
鳄鱼线,让趋势成为你的朋友

1. 策略核心观点
本文构建了一个包含短、中、长期综合考量的鳄鱼线投资策略。它通过吸纳不同时间跨度的信息生成投资信号。严格的多空信号标准使其有着优秀的beta收益。此外,通过不断地纳入AO、分形以及MACD因子,其投资表现越来越好。
2. 引言
tip
“你无法阻止波浪,但你可以学会冲浪。” —— 乔恩·卡巴金对于交易者而言,市场就像一片浩瀚的大海,时而风平浪静,时而波涛汹涌。许多人试图预测每一个浪花的起落,结果在反复的颠簸中耗尽心力。而真正的冲浪高手,他们从不追逐每一个微小的涟漪。他们会漂在冲浪板上,静静感受海水的流动,耐心等待那股足以形成完美浪管的巨大力量。
当“鳄鱼”从深海中苏醒,巨浪开始形成的瞬间,他们会果断转身,与趋势的力量融为一体。
今天,我们将要复现的“鳄鱼线”(Alligator Indicator)指标,正是这样一种“鳄鱼捕食”的哲学在量化交易中的完美体现。它由三条移动平均线组成,模拟鳄鱼的“嘴唇”、“牙齿”和“下颚”。通过观察这三条线的缠绕与发散,我们就能学会像顶级猎手一样,在趋势沉睡时保持耐心,在趋势苏醒时果断跟随。
3. 鳄鱼线的构成
该策略的核心就是以鳄鱼线为题展开的,可以说是生动形象。
理清一点呢,鳄鱼头是由白色上唇线(5天移动平均并向未来移动3天),黄色牙齿线(8天移动平均并向未来移动5天)和紫色下颚线(13天移动平均并向未来移动8天)构成。
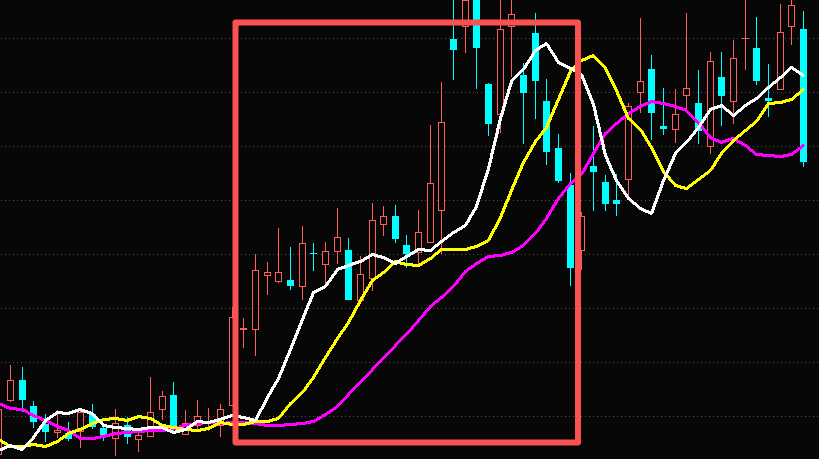
如图一,多头:上唇 > 牙齿 > 下颚(鳄鱼趴着,嘴向上张)三线自上而下依次为上唇、牙齿、下颚,且间距逐步拉开,说明快线带动中慢线向上推进,趋势有序发酵,此时做多。
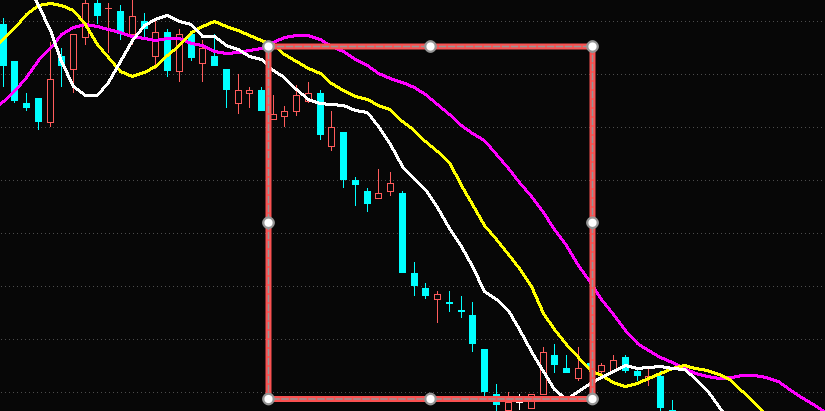
如图二,做空时鳄鱼线的头反过来(下颚>牙齿>上唇),像是死掉的鱼一点都不新鲜,因此做空。
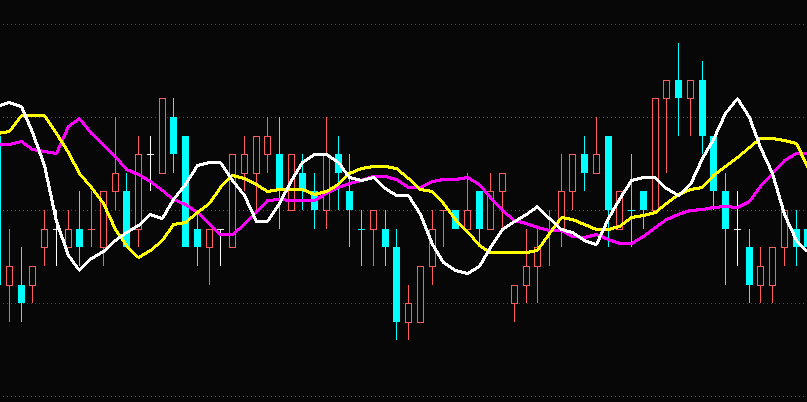
如图三,其他时候头歪着的鳄鱼我们也看不出来到底是死是活,因此空仓处理。
4. 鳄鱼线策略
价格序列:
$$O_t,;H_t,;L_t,;C_t$$
分别为开、高、低、收。
简单移动平均(SMA):
$$\operatorname{SMA}{n}(x)t=\frac{1}{n}\sum{i=0}^{n-1}x{t-i}$$
指数移动平均(EMA),(\alpha=\frac{2}{n+1}):
$$\operatorname{EMA}{n}(x)t=\alpha x_t+(1-\alpha)\operatorname{EMA}{n}(x){t-1}$$
向右平移 (k) 日(避免未来函数):
$$\operatorname{shift}_{+k}(x)t=x{t-k}$$
鳄鱼线 $$ \begin{aligned} \text{Jaw}t &= \operatorname{shift}{+8}\big(\operatorname{SMA}_{13}(C)\big)t \ \text{Teeth}t &= \operatorname{shift}{+5}\big(\operatorname{SMA}{8}(C)\big)t \ \text{Lips}t &= \operatorname{shift}{+3}\big(\operatorname{SMA}{5}(C)\big)_t \end{aligned} $$
状态判别:
$$ \begin{aligned} \text{bull}_t &:; \text{Lips}_t>\text{Teeth}_t>\text{Jaw}_t \ \text{bear}_t &:; \text{Lips}_t<\text{Teeth}_t<\text{Jaw}_t \end{aligned} $$
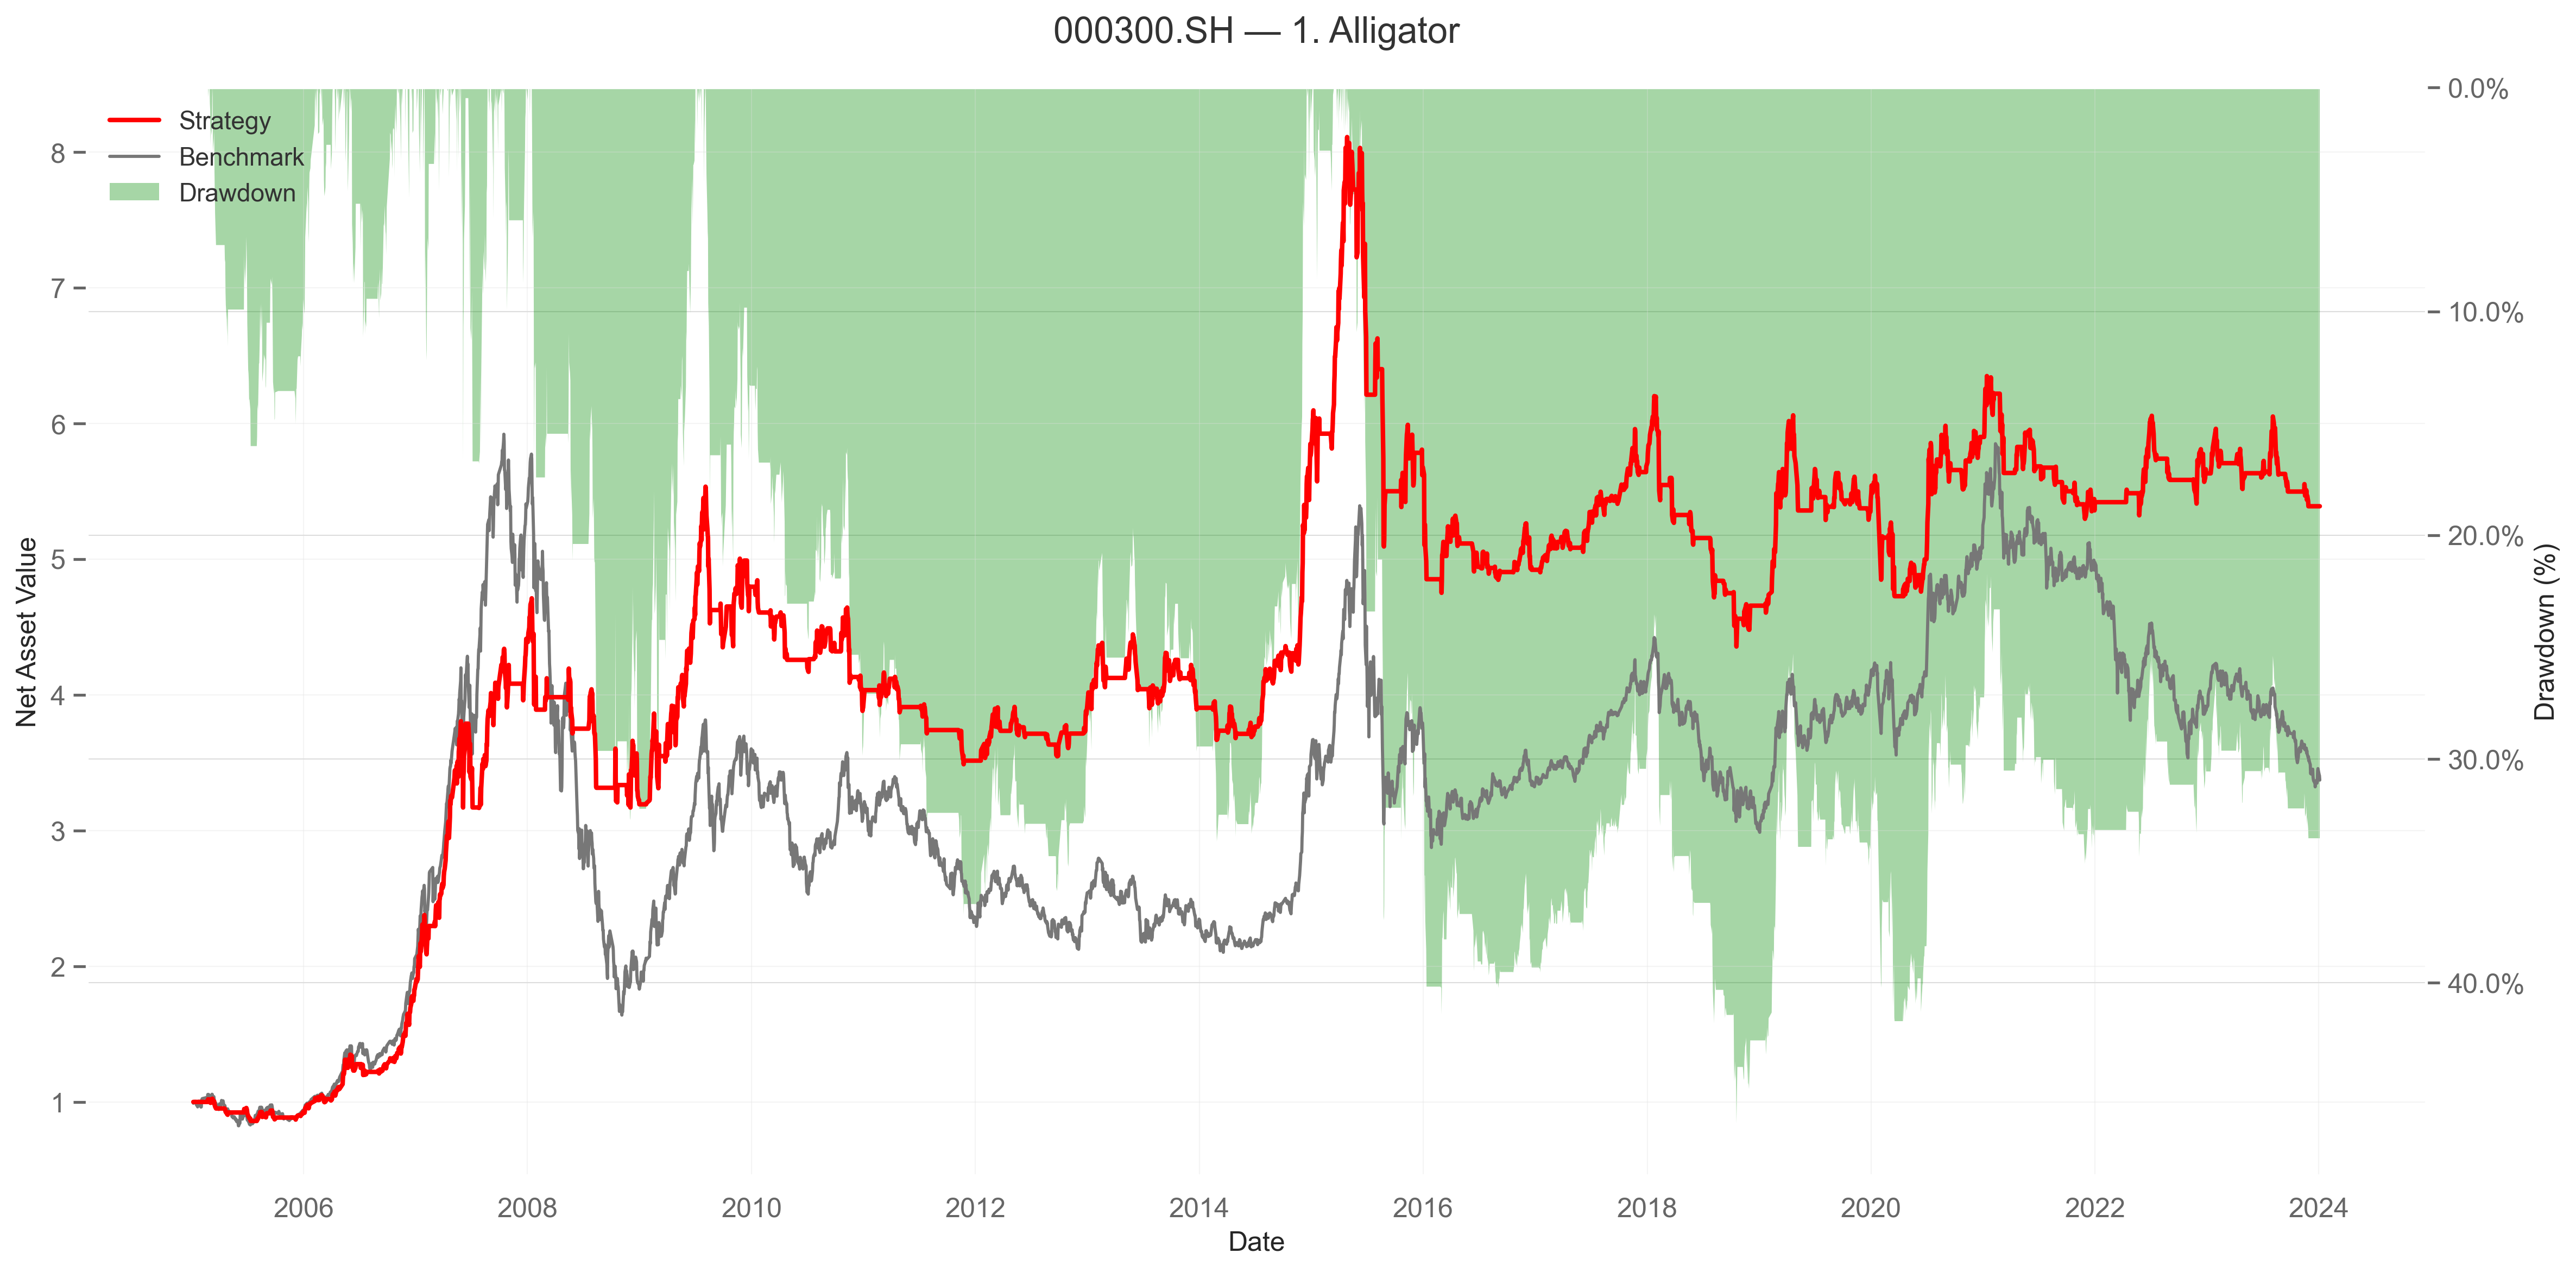
根据上证指数的回测结果(图四),我们可以发现: 1.在趋势市中,该指标能够有效捕捉主升浪,因此具有明显的趋势跟随特征。 2.震荡市中,鳄鱼线会频繁发出“假信号",导致交易过于频繁,收益表现呈现明显的β属性(跟随大盘),但α能力有限 3.在我们的回测结果中,单纯鳄鱼线的年化收益率约为9.9%,但最大回撤高达51%。 恐怖的回撤或许没有几个投资者把钱投入到这个单一策略中,同时也表明单一的 Aligator 难以形成稳健的择时逻辑。
因此,正是由于鳄鱼线的缺点,所以需要结合其他指标进行改进。
5. 鳄鱼线+AO
AO为5日与34日价格均差:刻画短中期动量,并以“三连升/三连降”约束连续性;
$$ \begin{aligned} M_t &= \frac{H_t+L_t}{2} \ \operatorname{AO}t &= \operatorname{SMA}{5}(M)t - \operatorname{SMA}{34}(M)_t \end{aligned} $$
三连升/三连降:
$$ \begin{aligned} \text{AO:rising3}t &:; \operatorname{AO}t>\operatorname{AO}{t-1}>\operatorname{AO}{t-2} \ \text{AO:falling3}t &:; \operatorname{AO}t<\operatorname{AO}{t-1}<\operatorname{AO}{t-2} \end{aligned} $$
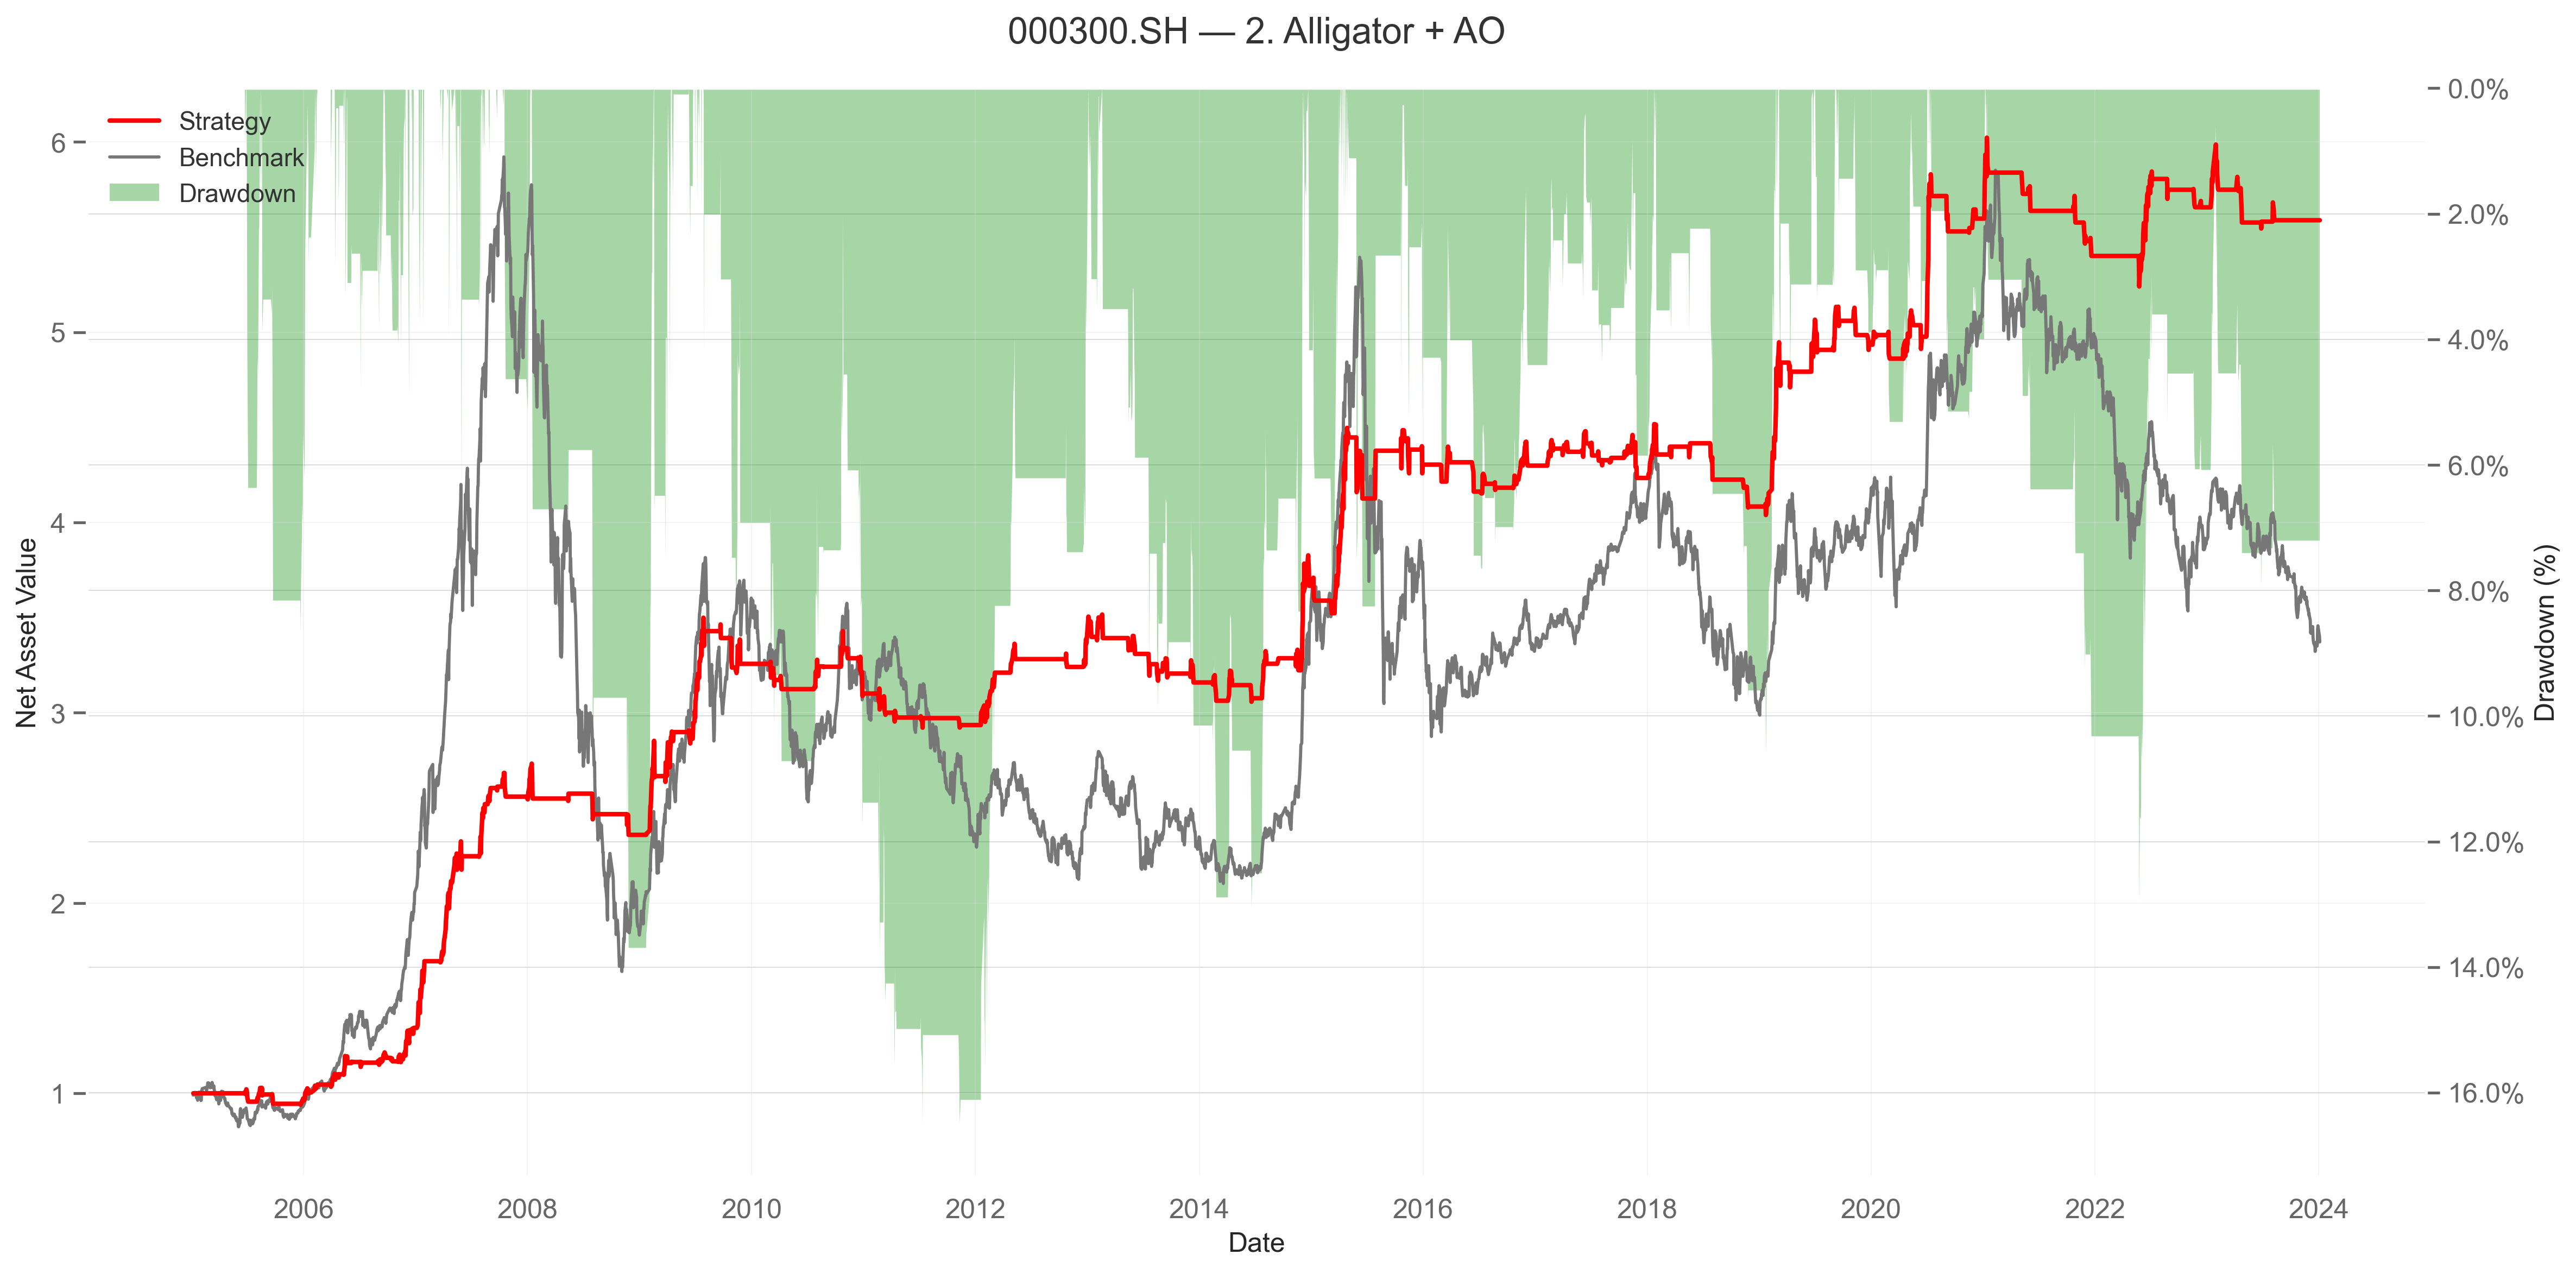
在执行上以鳄鱼线判趋势结构(张口方向),AO 判力度与持续性,仅在“张口向上且 AO 连升”时进场,“收口或 AO 连降/转负”时离场,从而显著削弱震荡期假突破与无效交易。 上证的结果显示:相对单鳄鱼线年化约 9.9%、最大回撤约 51% 的脆弱性,引入 AO 后最大回撤降至约 16%,交易频率与噪声同步下降。
6. 鳄鱼线+AO+分形
分形是“5 根 K 线的局部极值”记号:上分形的中间那根有全组最高点,下分形的中间那根有全组最低点,等第 5 根收盘后才确认,再把最近一次分形价前向填充成“最近上/下分形”作为动态阻力/支撑。
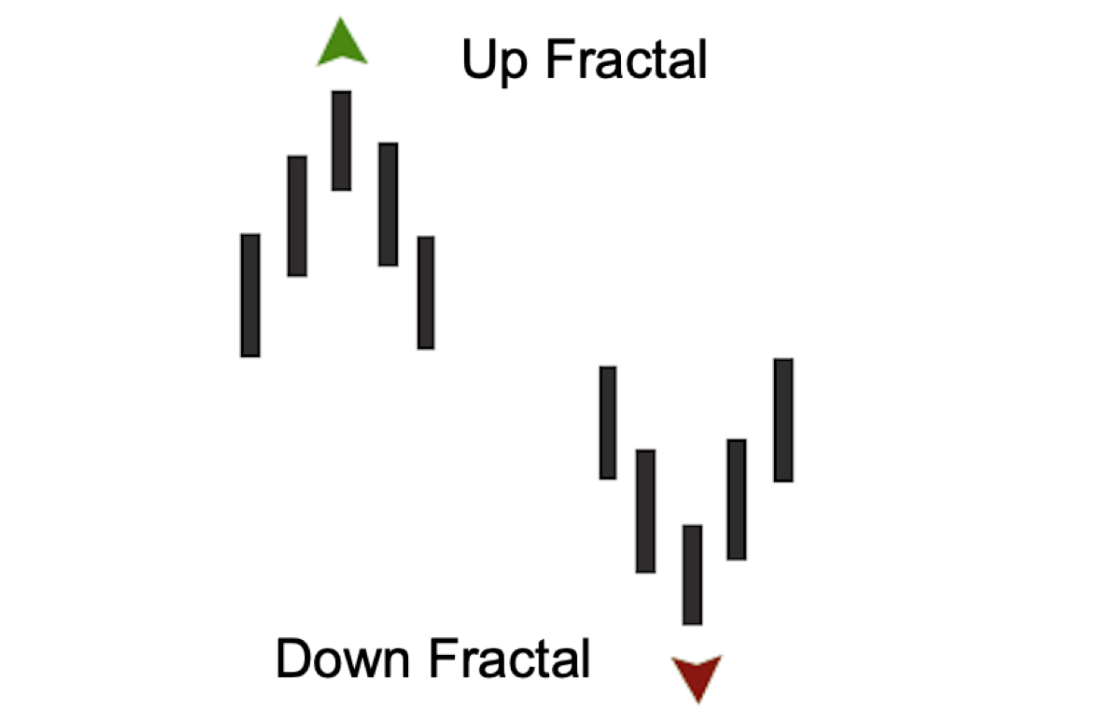
如图六所示,绿色结构为上分形,红色结构更为下分形 分形检测:
$$ \begin{aligned} \text{UpFrac at }t &: H_t\ge H_{t-1}\land H_t\ge H_{t-2}\land H_t\ge H_{t+1}\land H_t\ge H_{t+2} \ \text{DnFrac at }t &: L_t\le L_{t-1}\land L_t\le L_{t-2}\land L_t\le L_{t+1}\land L_t\le L_{t+2} \end{aligned} $$
在 (t+2) 日发布分形价位:
$$ \begin{aligned} \text{FracUp}t &= \operatorname{shift}{+2}\big(1_{\text{UpFrac at }t}\cdot H_t\big) \ \text{FracDn}t &= \operatorname{shift}{+2}\big(1_{\text{DnFrac at }t}\cdot L_t\big) \end{aligned} $$
前向填充最近已发布分形:
$$ \begin{aligned} \text{FracUpRecent}_t &= \max{\text{FracUp}_s \mid s\le t\text{ 且非空}} \ \text{FracDnRecent}_t &= \min{\text{FracDn}_s \mid s\le t\text{ 且非空}} \end{aligned} $$
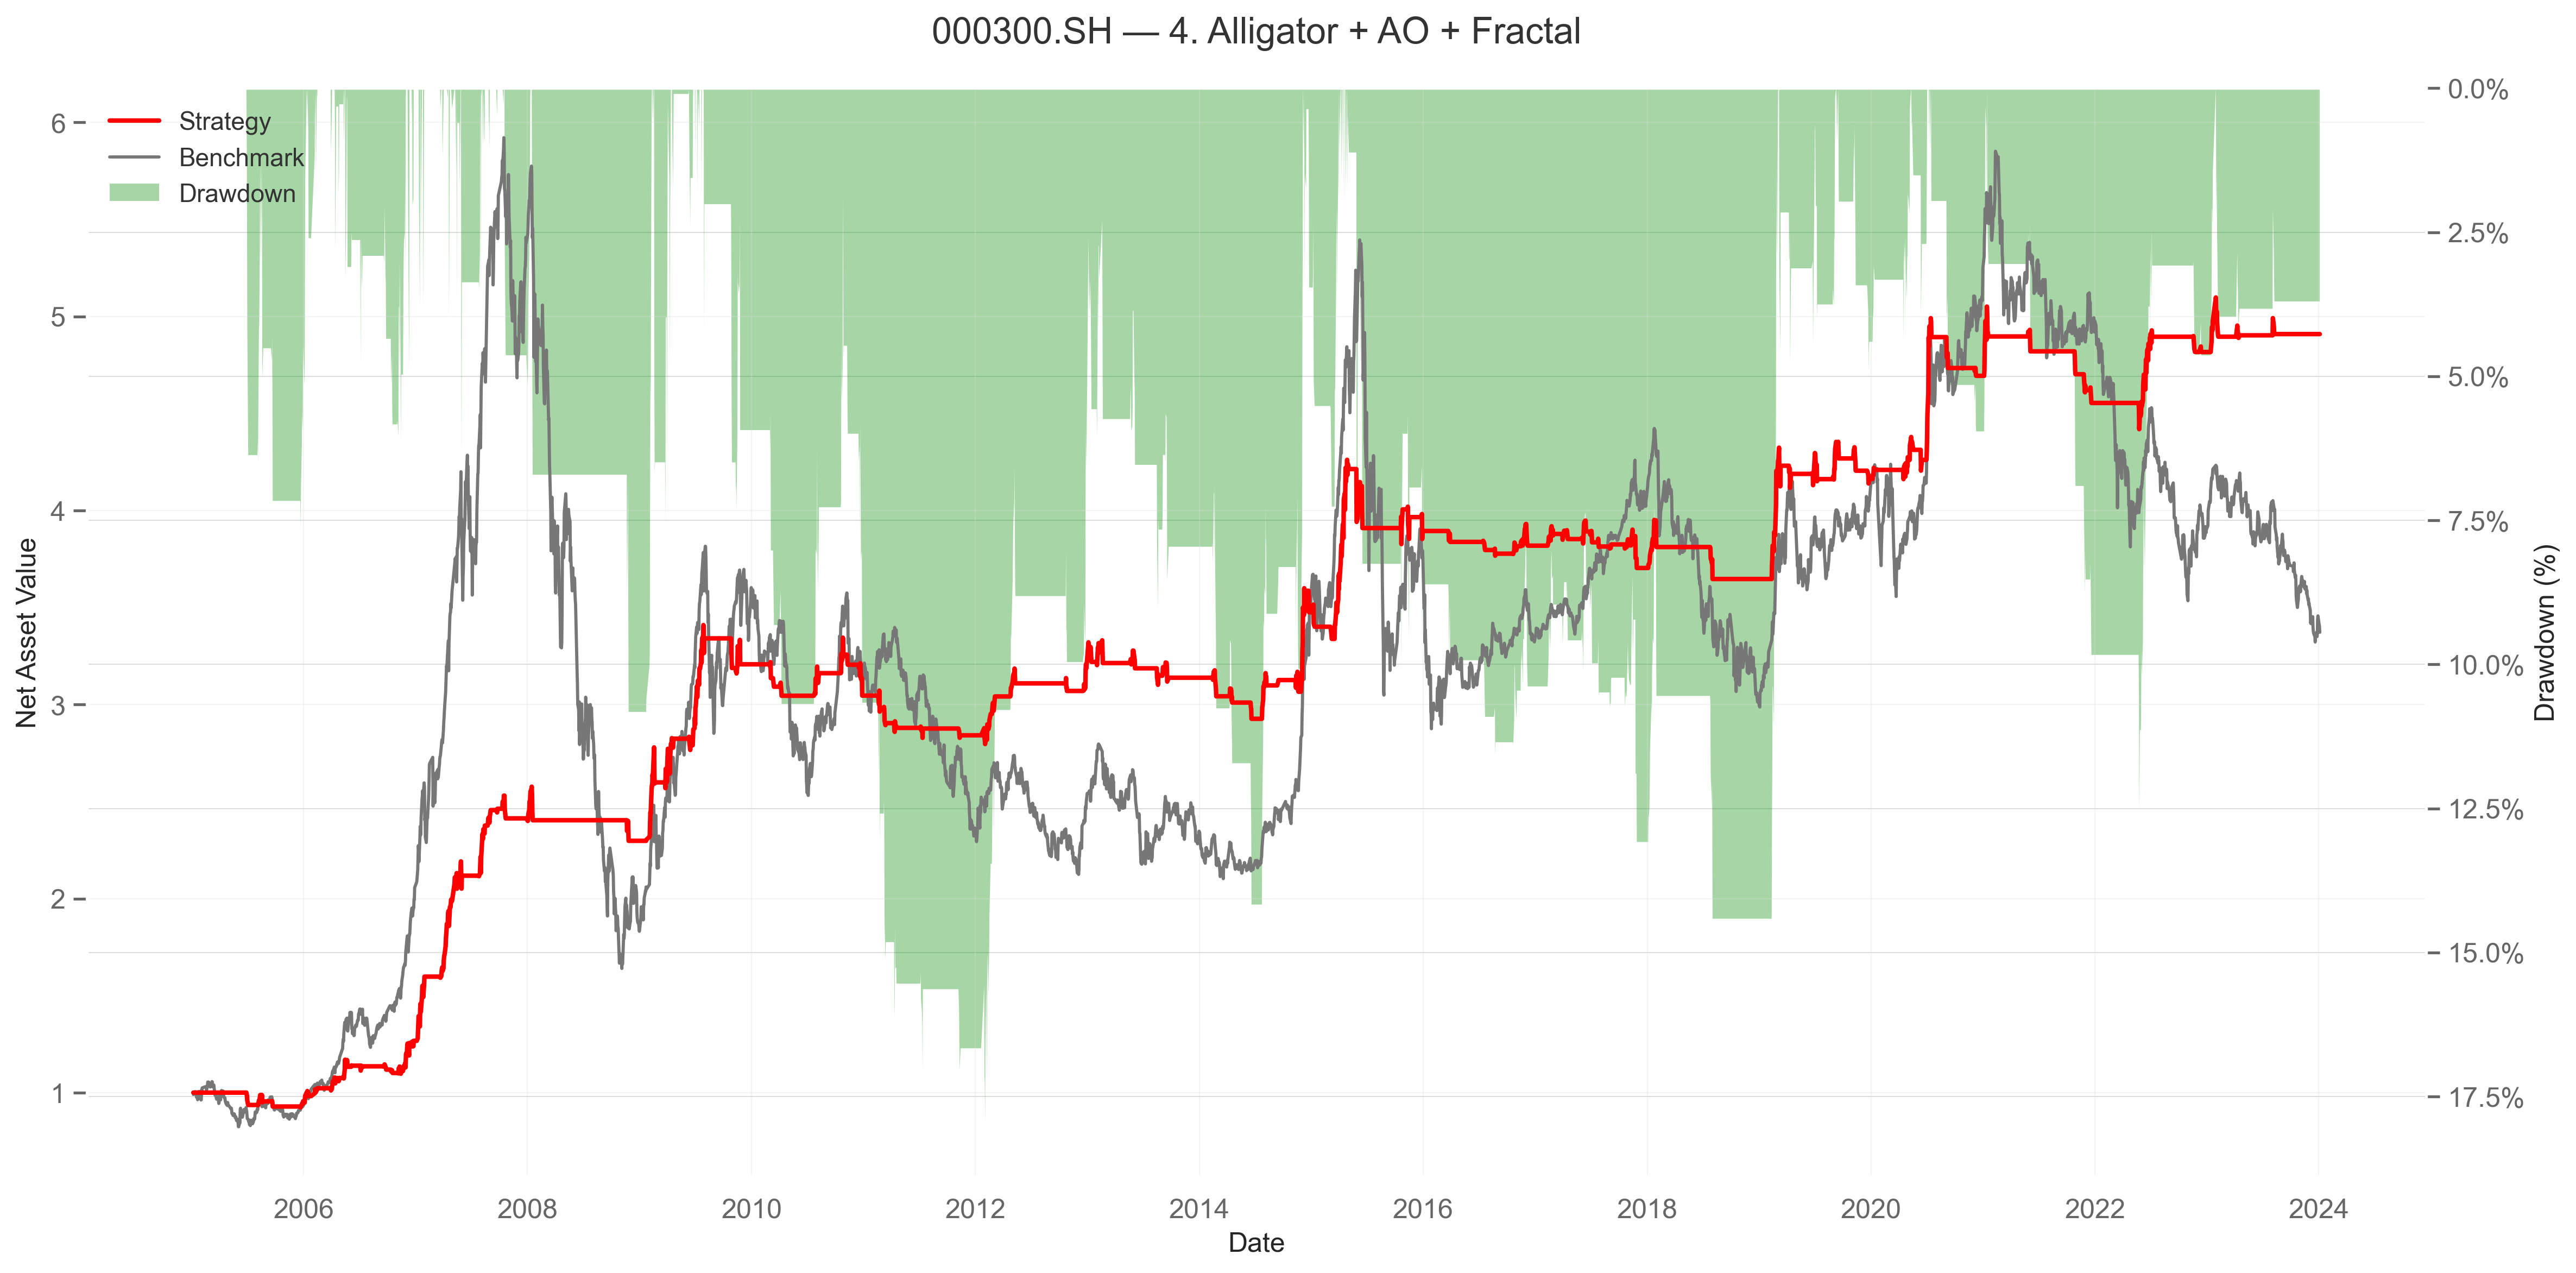
策略上先以鳄鱼线与 AO 筛“方向与力度”,再要求“收盘有效突破最近上分形”才开多、跌破最近下分形或鳄鱼线收口则离场,形成“结构→力度→价位”的三级闸门。 这样可避免“刚买就撞阻力”的低质量入场,使净值更平滑、回撤更短更浅,但由于分形发布存在 t+2 滞后,强趋势早段会让渡部分利润,整体性价比仍优于频繁误判。
7. 鳄鱼线+AO+分形+MACD
MACD是用两条指数均线差(DIF=EMA12−EMA26)和其信号线(DEA=EMA9 的 DIF)来给“节奏确认”,用来判断“是否进入/退出一段新节拍”。
$$ \begin{aligned} \text{DIF}t &= \operatorname{EMA}{12}(C)t - \operatorname{EMA}{26}(C)_t \ \text{DEA}t &= \operatorname{EMA}{9}(\text{DIF})_t \ \text{HIST}_t &= 2\cdot\big(\text{DIF}_t-\text{DEA}_t\big) \end{aligned} $$
交叉信号:
$$ \begin{aligned} \text{GoldenCross}_t &: \text{DIF}t>\text{DEA}t\cap \text{DIF}{t-1}\le \text{DEA}{t-1} \ \text{DeadCross}_t &: \text{DIF}t<\text{DEA}t\cap \text{DIF}{t-1}\ge \text{DEA}{t-1} \end{aligned} $$
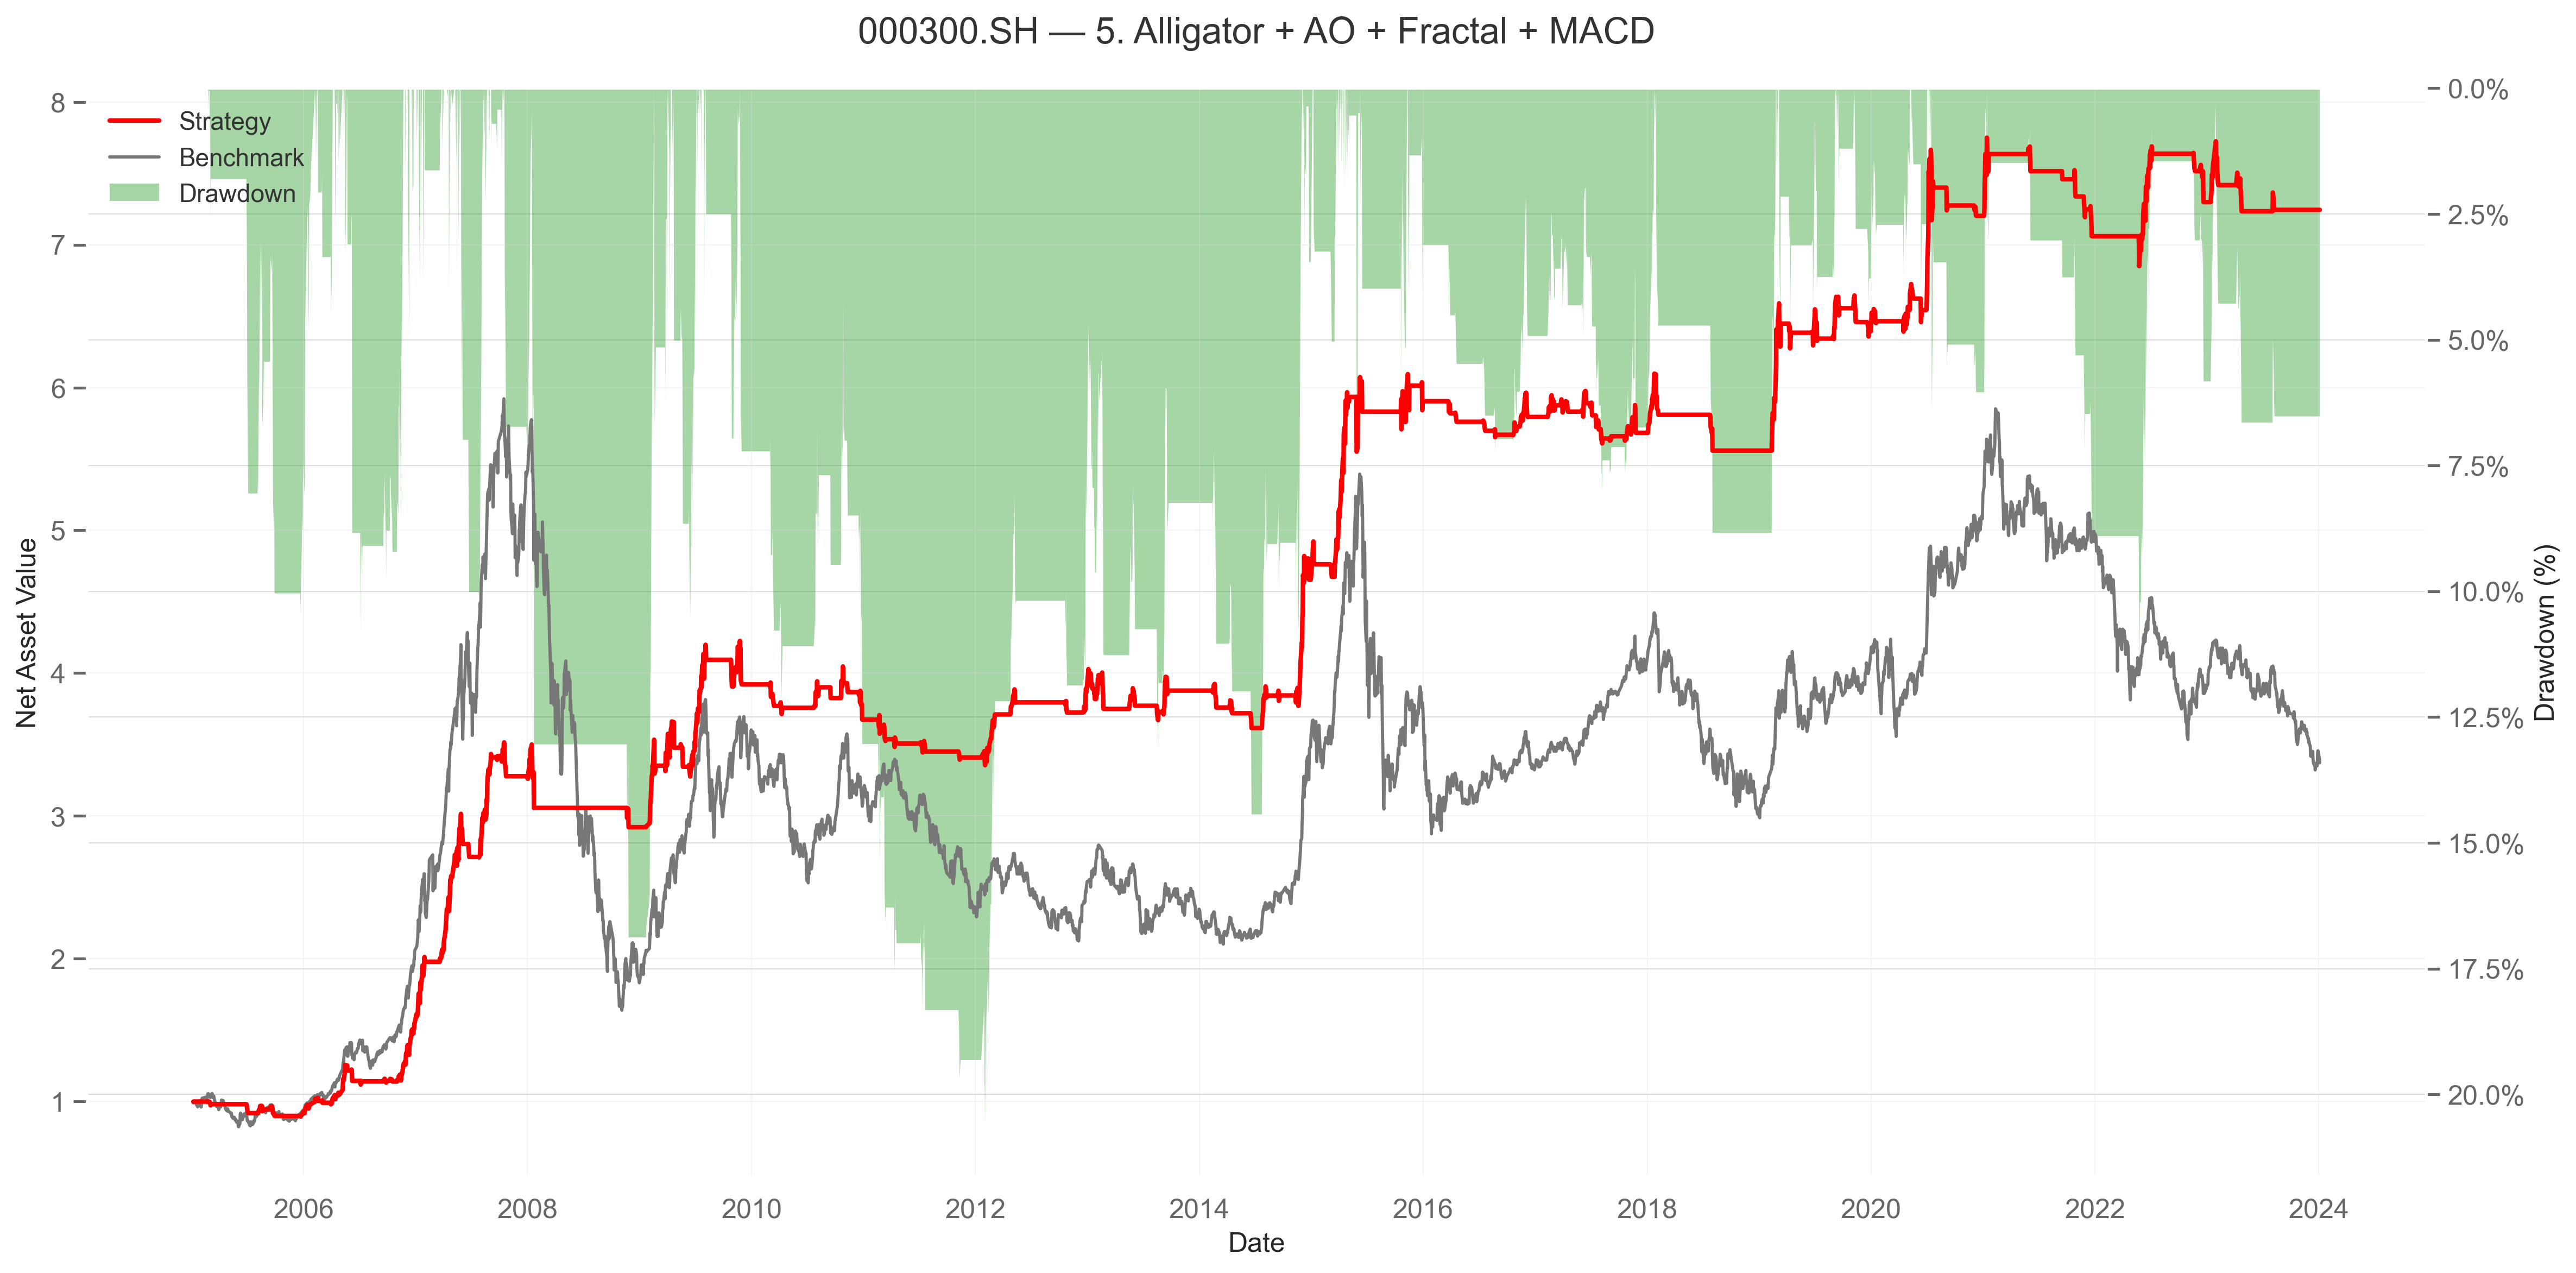
在结构、力度与价位三关后加入 MACD(金叉/死叉)作为节奏确认:仅当鳄鱼线张口向上、AO 连升、分形位被收盘突破且 MACD 金叉共振时进场,任一否决或 MACD 死叉时退出,从“是否突破”延伸到“是否进入新节拍”。 该组合进一步减少假突破后的迅速回杀,缩短回撤持续期并压低波动,但多重均线系信号叠加会带来进场更晚的代价,需用交易成本与参数稳健性测试校准窗长。
8. 鳄鱼线+AO+分形+MACD的股债轮动
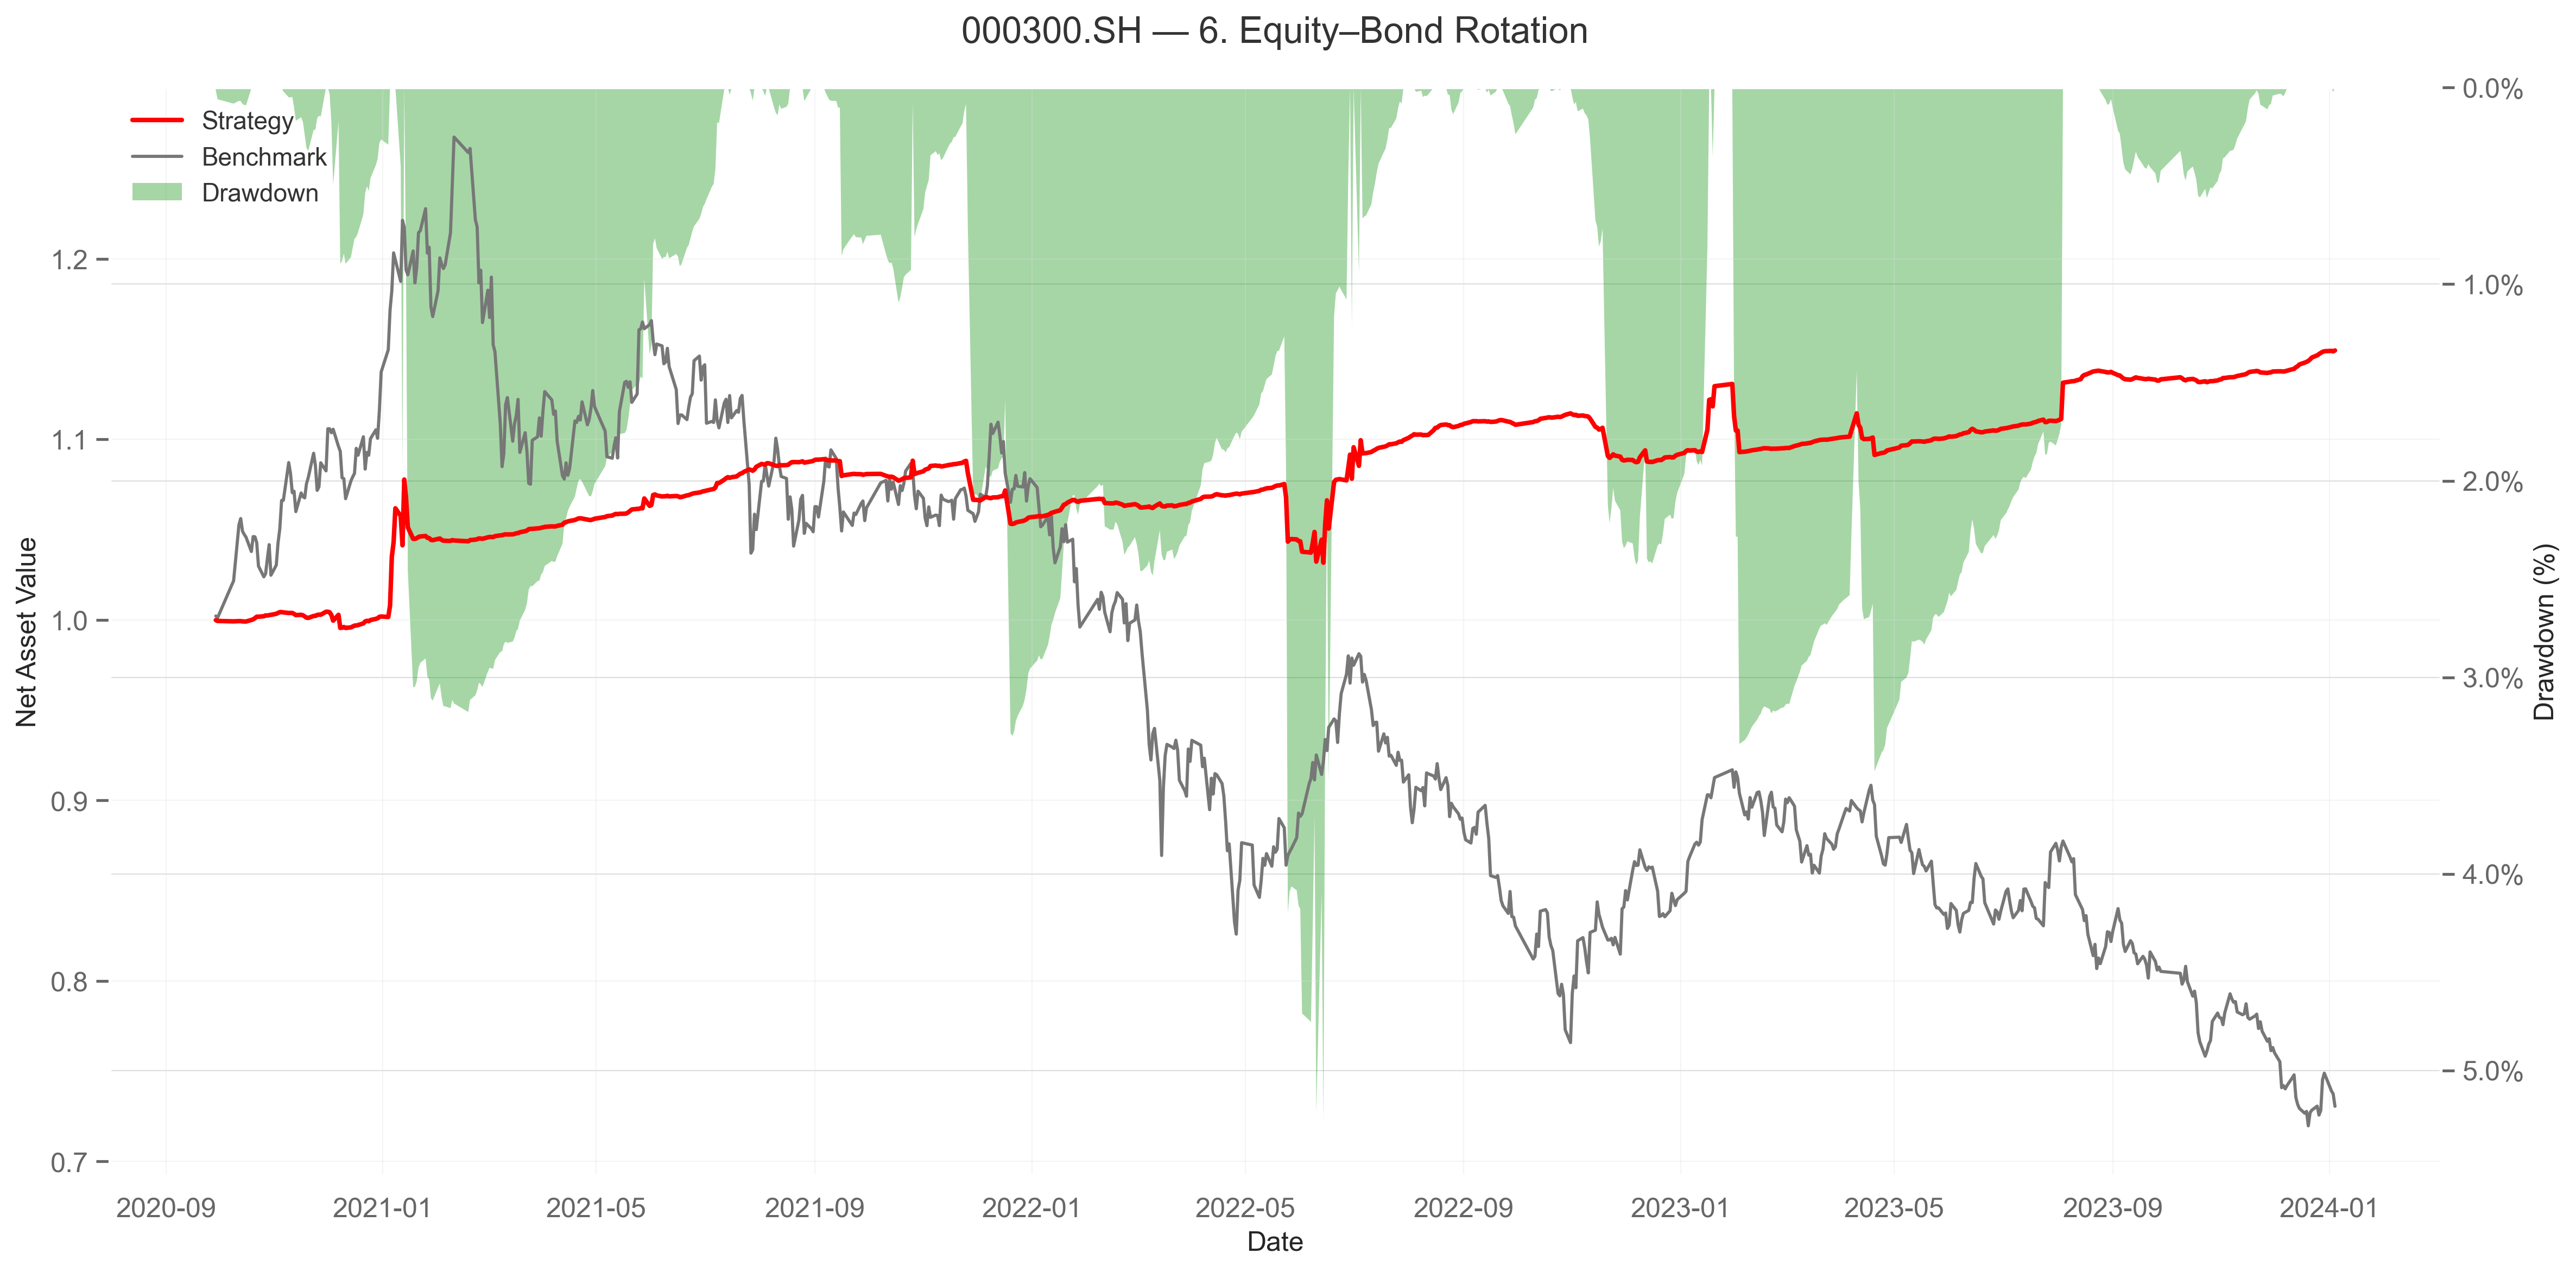
当多信号不满足而判定“空仓”时,以债券指数或低波固收替代资产承接资金,待信号再度共振时切回股票,从而把择时空窗转化为稳态收益、显著拉直资金曲线并降低最大回撤与回撤时间; 在牛短熊长的 A 股环境下,该机制提升了 Alpha 能见度与资金利用率。
9. 指标对比
前文均是一个因子一个因子叠加地研究,所以并未针对单独一个因子看看效果,如果我们一开始是用鳄鱼线加上分形,结果会如何呢?
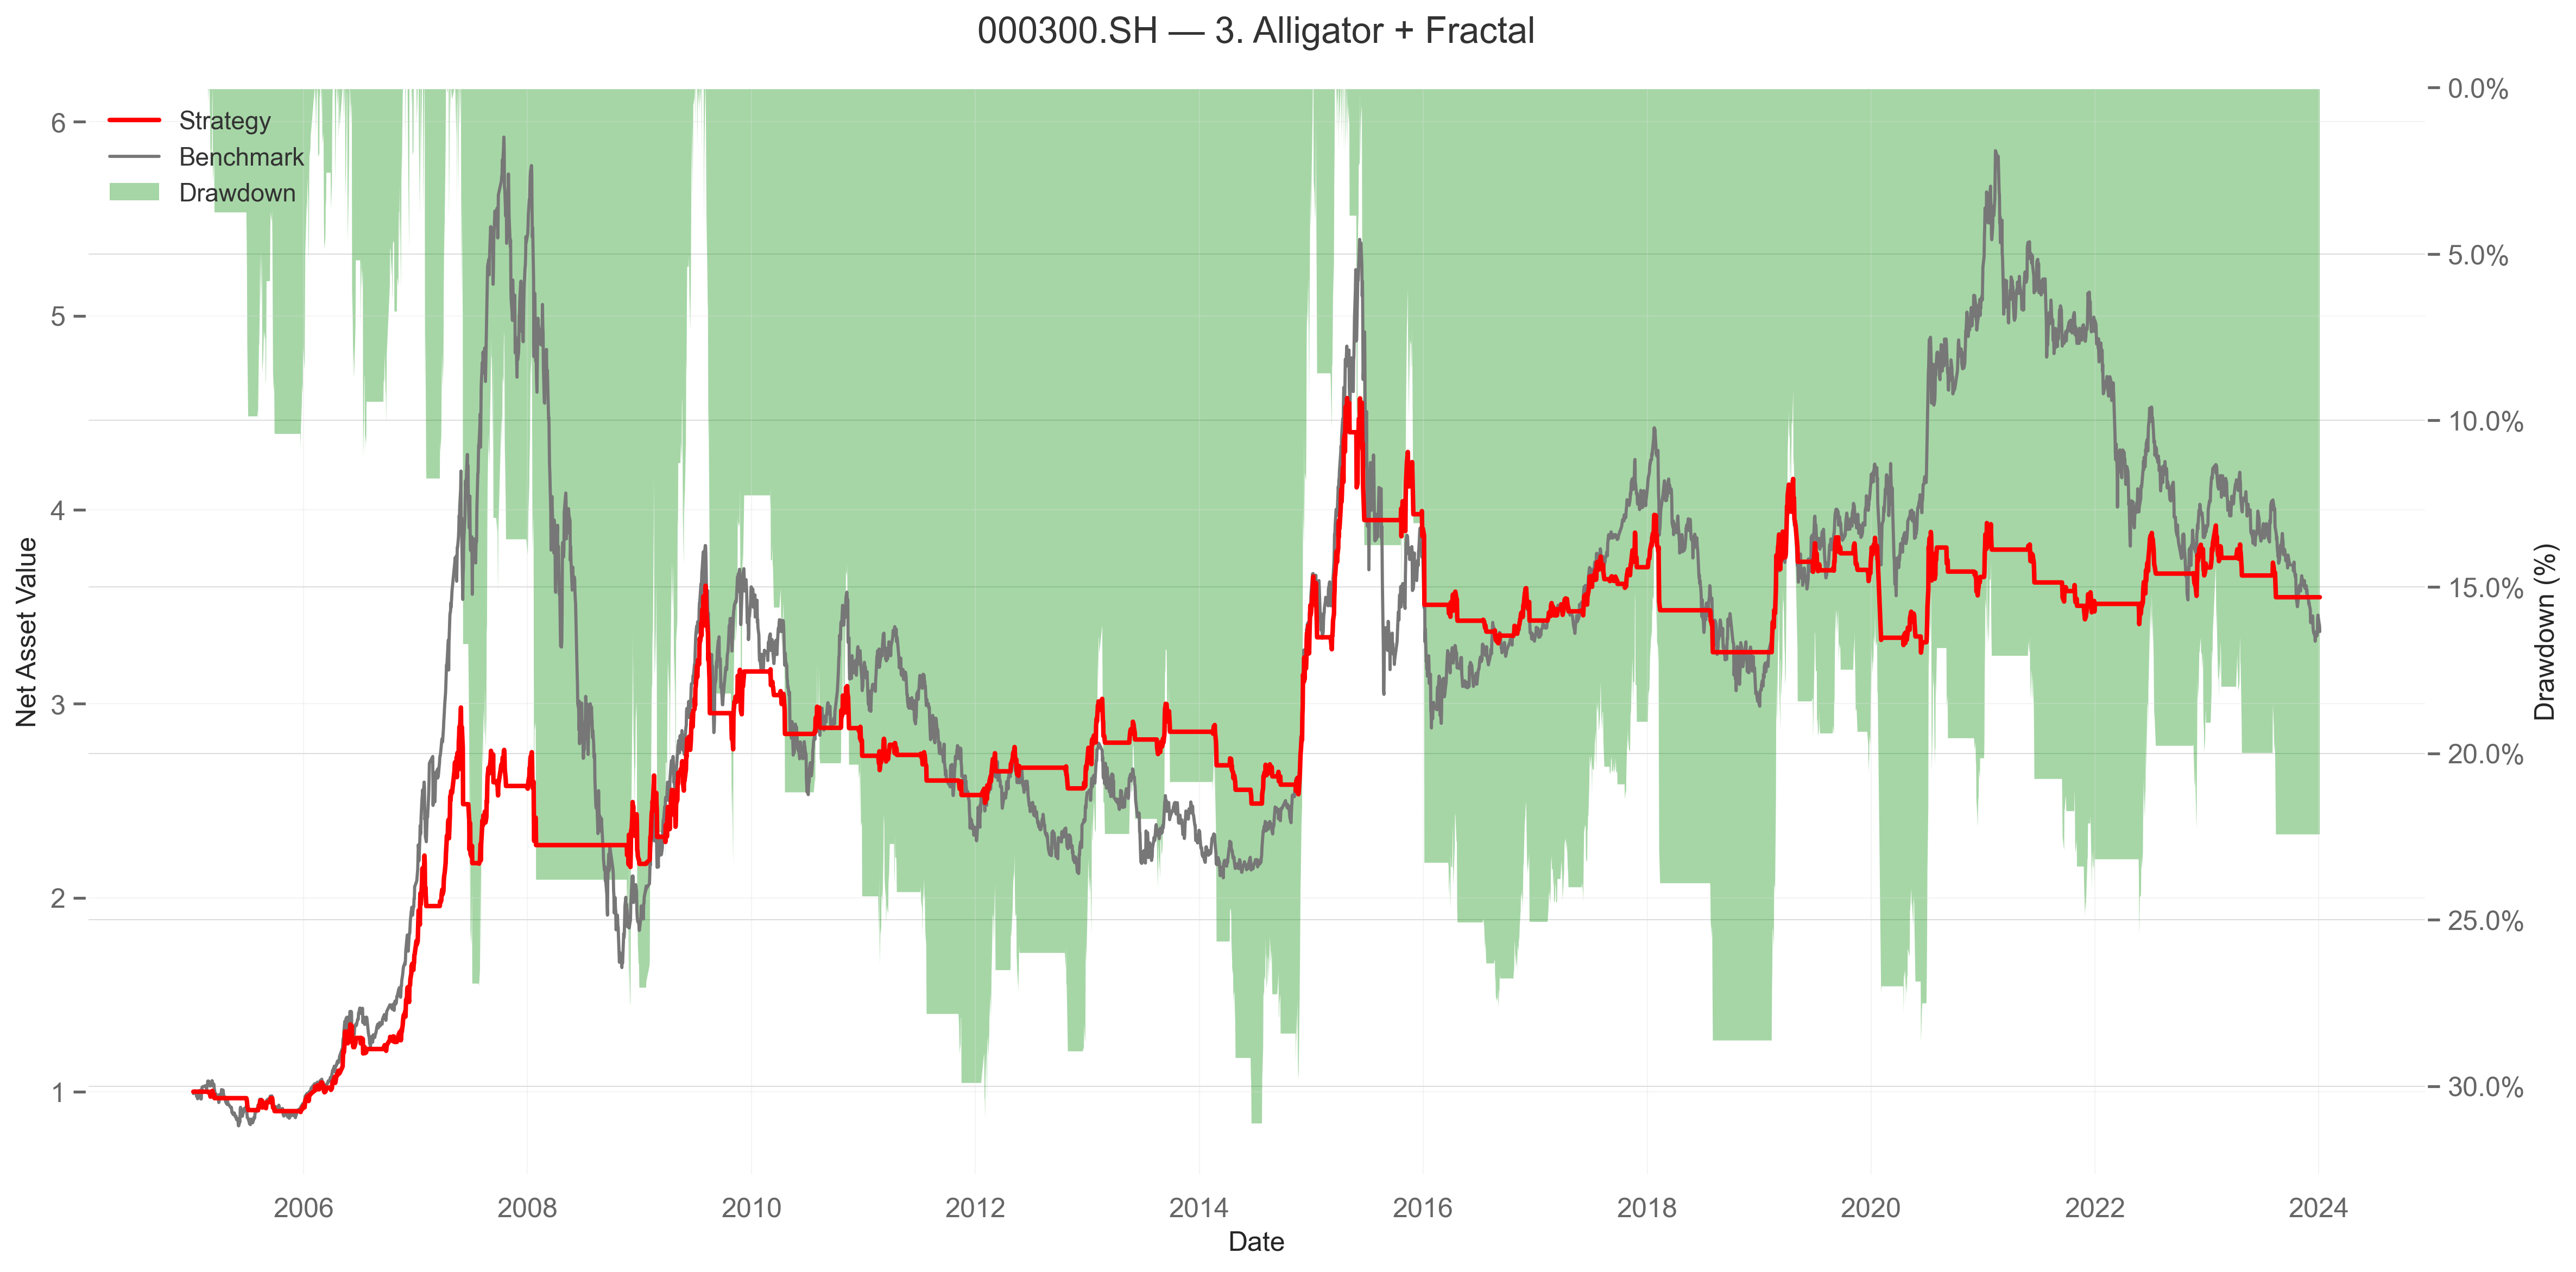
发现单纯加入分形后回撤情况并未有很大改善
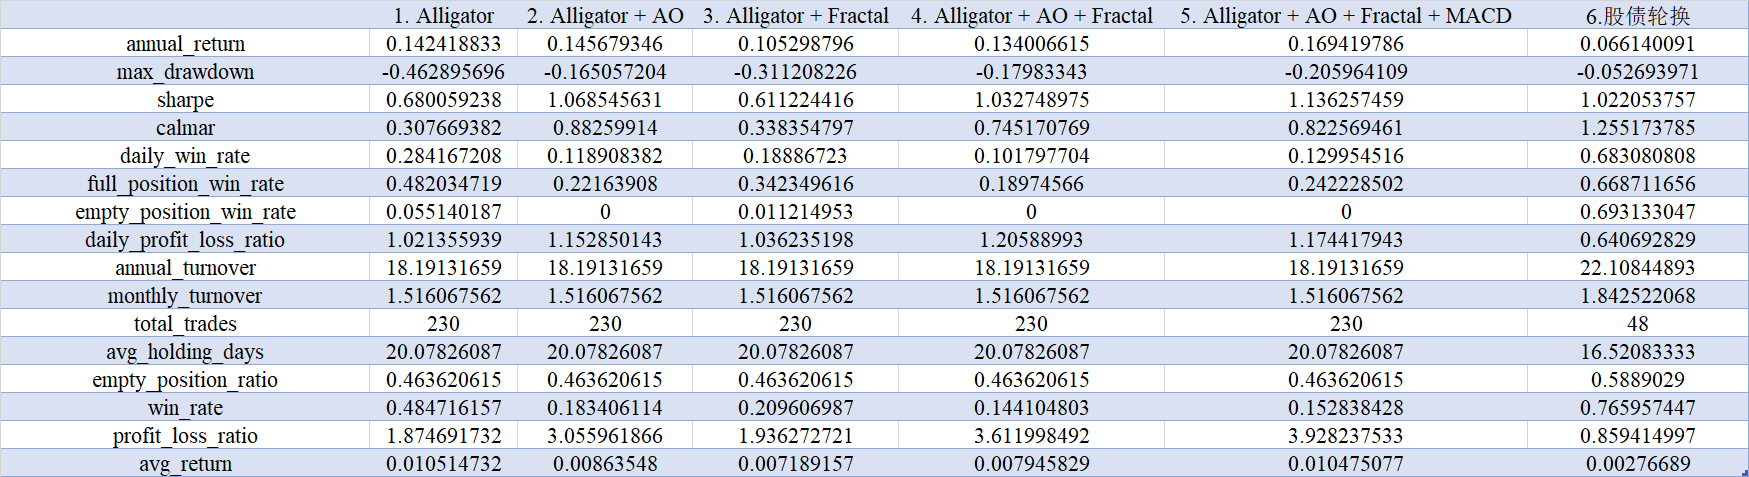
加入更多因子后是什么导致的夏普的提高、回撤的减少,可以看到随着指标的逐项加入,盈亏比的提高是很关键的。 但是谁最有用? 很明显是AO,加入AO后盈亏比提高巨大这样使得即使交易会亏损但只亏一点,一赚就赚一大笔。 其他分形,macd其实看起来提升效果较AO来说就比较小了 读者若有兴趣可以对AO进行因子分析。 除了鳄鱼线之外,还有其他以动物名称命名的因子,比如狼波,三只乌鸦,龙线等,都是技术指标层面的分析,感兴趣的朋友也可以搜索了解一下。
info
根据尤金·法玛的有效市场理论,我们靠技术分析能盈利的原因归根结底就是信息反映的不充分,而国内的各种交易限制刚好提供了这种结构性摩擦,大量非理性的散户操作也给了我们套利空间,我们需要的不是爱上某个形态,而是把它变成可被验证、可被替换的模块。10. 代码
10.1. 因子计算
from typing import List, Optional
from pathlib import Path
import tushare as ts
import pandas as pd
import os
pro = ts.pro_api()

data_dir = str(data_home / "rw/alligator/data")
factor_dir = str(data_home / "rw/alligator/factor")
signal_dir = str(data_home / "rw/alligator/signal")
report_dir = str(get_jupyter_root_dir() / "reports/alligator/")
universe = ['000300.SH',"000001.SH","000852.SH","000905.SH","000985.CSI","CBA00101.CS"]

def _prepare_df(df: pd.DataFrame) -> pd.DataFrame:
    """确保 trade_date 升序、关键列为数值。"""
    if "trade_date" not in df.columns:
        raise ValueError("缺少 trade_date 列")

    df = df.copy()
    df["trade_date"] = pd.to_datetime(df["trade_date"].astype(str), errors="coerce")
    df = df.dropna(subset=["trade_date"]).sort_values("trade_date").reset_index(drop=True)

    # 转数值
    for c in ["open", "high", "low", "close"]:
        if c in df.columns:
            df[c] = pd.to_numeric(df[c], errors="coerce")

    return df

def get_index_daily_data(ts_codes: List[str],
                          start_date: Optional[str] = None,
                          end_date: Optional[str] = None,
                          save_path: str = data_dir) -> None:
     os.makedirs(save_path, exist_ok=True)
     for ts_code in ts_codes:
         df = pro.index_daily(ts_code=ts_code, start_date=start_date, end_date=end_date)
         if df is None or df.empty:
             print(f"[warn] 无数据: {ts_code}")
             continue
         df = _prepare_df(df)
         out = os.path.join(save_path, f"{ts_code}.parquet")
         df.to_parquet(out, index=False)
         print(f"[ok] 保存: {out}")

get_index_daily_data(
         ts_codes=universe,
         start_date="20040630",
         end_date="20250901"
     )
def _clip_by_date(
    df: pd.DataFrame,
    start: Optional[pd.Timestamp | str],
    end: Optional[pd.Timestamp | str],
) -> pd.DataFrame:
    if start is not None:
        start = pd.to_datetime(start)
        df = df[df["trade_date"] >= start]
    if end is not None:
        end = pd.to_datetime(end)
        df = df[df["trade_date"] <= end]
    return df
10.1.1. Alligator
# ============== 指标计算 ==============

def calculate_alligator(df: pd.DataFrame) -> pd.DataFrame:
    """
    Alligator(SMA)并右移:
    Jaw=13 shift(8), Teeth=8 shift(5), Lips=5 shift(3)
    状态:
      bull: lips > teeth > jaw
      bear: lips < teeth < jaw
      否则 neutral
    """
    df = _prepare_df(df)
    close = df["close"]

    df["alligator_jaw"]   = close.rolling(13).mean().shift(8)
    df["alligator_teeth"] = close.rolling(8).mean().shift(5)
    df["alligator_lips"]  = close.rolling(5).mean().shift(3)

    bull = (df["alligator_lips"] > df["alligator_teeth"]) & (df["alligator_teeth"] > df["alligator_jaw"])
    bear = (df["alligator_lips"] < df["alligator_teeth"]) & (df["alligator_teeth"] < df["alligator_jaw"])

    df["alligator_state"] = "neutral"
    df.loc[bull, "alligator_state"] = "bull"
    df.loc[bear, "alligator_state"] = "bear"
    return df
10.1.2. Awesome Oscillator
def calculate_ao(df: pd.DataFrame) -> pd.DataFrame:
    """
    AO = SMA(median,5) - SMA(median,34)
    连涨3天:AO_t > AO_{t-1} > AO_{t-2}
    连跌3天:AO_t < AO_{t-1} < AO_{t-2}
    """
    df = _prepare_df(df)
    if not {"high", "low"}.issubset(df.columns):
        # 缺列则给空占位
        df["ao"] = pd.NA
        df["ao_rising3"] = False
        df["ao_falling3"] = False
        return df

    median_price = (df["high"] + df["low"]) / 2.0
    ao_short = median_price.rolling(5).mean()
    ao_long = median_price.rolling(34).mean()
    df["ao"] = ao_short - ao_long

    ao = df["ao"]
    df["ao_rising3"] = (ao > ao.shift(1)) & (ao.shift(1) > ao.shift(2))
    df["ao_falling3"] = (ao < ao.shift(1)) & (ao.shift(1) < ao.shift(2))
    return df
10.1.3. Fractals
def calculate_fractals(df: pd.DataFrame) -> pd.DataFrame:
    """
    分形允许等号,t±2 检测;整体 shift(+2) 发布,再 ffill 维持最近分形。
    输出: fractal_up, fractal_dn, fractal_up_recent, fractal_dn_recent
    """
    df = _prepare_df(df)
    if not {"high", "low"}.issubset(df.columns):
        for c in ["fractal_up", "fractal_dn", "fractal_up_recent", "fractal_dn_recent"]:
            df[c] = pd.NA
        return df

    highs, lows = df["high"], df["low"]

    up = (highs.shift(2) <= highs.shift(1)) & (highs.shift(1) <= highs) & \
         (highs.shift(-1) <= highs) & (highs.shift(-2) <= highs)
    dn = (lows.shift(2)  >= lows.shift(1))  & (lows.shift(1)  >= lows)  & \
         (lows.shift(-1)  >= lows)          & (lows.shift(-2)  >= lows)

    # 检测点放在 t,然后整体滞后发布到 t+2
    fr_up = pd.Series(pd.NA, index=df.index)
    fr_dn = pd.Series(pd.NA, index=df.index)
    fr_up[up] = highs[up]
    fr_dn[dn] = lows[dn]

    df["fractal_up"] = fr_up.shift(2)
    df["fractal_dn"] = fr_dn.shift(2)

    df["fractal_up_recent"] = df["fractal_up"].ffill()
    df["fractal_dn_recent"] = df["fractal_dn"].ffill()
    return df
10.1.4. MACD
def calculate_macd(df: pd.DataFrame) -> pd.DataFrame:
    """
    MACD 固参:12/26/9
    金叉/死叉用 DIF 与 DEA 的穿越
    “水上/零轴/水下”按“交叉当日 DIF 的正负”分类,不用 diff==0
    输出:macd_diff, macd_dea, macd_hist, macd_long, macd_short
    """
    df = _prepare_df(df)
    close = df["close"]

    ema12 = close.ewm(span=12, adjust=False).mean()  # 12日EMA
    ema26 = close.ewm(span=26, adjust=False).mean()  # 26日EMA
    diff = ema12 - ema26  # DIF线(快速线)
    dea = diff.ewm(span=9, adjust=False).mean()  # DEA线(慢速线)
    hist = 2 * (diff - dea)  # MACD直方图

    df["macd_diff"] = diff
    df["macd_dea"] = dea
    df["macd_hist"] = hist

    # 金叉和死叉判断
    golden = (diff > dea) & (diff.shift(1) <= dea.shift(1))  # DIF上穿DEA:金叉
    dead = (diff < dea) & (diff.shift(1) >= dea.shift(1))    # DIF下穿DEA:死叉

    # 水上金叉和水下金叉
    above_golden = golden & (diff > 0)  # DIF在零轴上金叉
    zero_golden = golden & (diff <= 0)  # DIF在零轴下金叉
    below_dead = dead & (diff < 0)     # DIF在零轴下死叉
    zero_dead = dead & (diff >= 0)     # DIF在零轴上死叉

    # 生成MACD的多空信号
    df["macd_long"] = above_golden | zero_golden
    df["macd_short"] = below_dead | zero_dead

    return df  # MACD四象限合成信号(由gen_factor计算)
10.1.5. IO 管线
def read_parquet_files(
    data_folder: str = data_dir
) -> Dict[str, pd.DataFrame]:
    """
    读取 data_folder 下所有 .parquet,返回 {ts_code: df}
    要求文件名即 ts_code,如 000001.SH.parquet
    """
    data: Dict[str, pd.DataFrame] = {}
    if not os.path.exists(data_folder):
        raise FileNotFoundError(f"数据目录不存在: {data_folder}")

    files = [f for f in os.listdir(data_folder) if f.endswith(".parquet")]
    if not files:
        print(f"[warn] 目录无 parquet 文件: {data_folder}")

    for file in files:
        ts_code = file.replace(".parquet", "")
        path = os.path.join(data_folder, file)
        df = pd.read_parquet(path)
        df = _prepare_df(df)
        data[ts_code] = df
    return data
def _compute_all_factors(df: pd.DataFrame) -> pd.DataFrame:
    """在单个 df 上依次计算所有指标(保持列齐全)。"""
    df1 = calculate_alligator(df)
    df2 = calculate_ao(df1)
    df3 = calculate_fractals(df2)
    df4 = calculate_macd(df3)
    return df4
def save_alligator_to_parquet(
    data: Dict[str, pd.DataFrame],
    factor_folder: Path = factor_dir,
    factor_start_date: Optional[str] = None,
    factor_end_date: Optional[str] = None,
) -> None:
    """
    计算指标并保存为 parquet:{factor_folder}/{ts_code}_alligator.parquet
    可在因子阶段用 factor_start_date / factor_end_date 裁剪
    """
    os.makedirs(factor_folder, exist_ok=True)

    for ts_code, df in data.items():
        # 裁剪窗口仅作用于“因子计算阶段”,后续策略/回测再自行设窗口
        df_clip = _clip_by_date(df, factor_start_date, factor_end_date)
        if df_clip.empty:
            print(f"[warn] {ts_code} 在所选时间窗无数据,跳过")
            continue

        out_df = _compute_all_factors(df_clip)
        out_path = os.path.join(factor_folder, f"{ts_code}_alligator.parquet")
        out_df.to_parquet(out_path, index=False)
        print(f"[ok] {ts_code} 因子保存 -> {out_path}")
def process_alligator_from_data(
    data_folder: str = data_dir,
    factor_folder: str = factor_dir,
    factor_start_date: Optional[str] = None,
    factor_end_date: Optional[str] = None,
) -> None:
    """
    从 data_folder 读取行情,计算因子,保存至 factor_folder
    """
    data = read_parquet_files(data_folder=data_folder)
    save_alligator_to_parquet(
        data,
        factor_folder=factor_folder,
        factor_start_date=factor_start_date,
        factor_end_date=factor_end_date,
    )
10.1.6. 入口函数
def run_all(
    data_folder: str = data_dir,
    factor_folder: str = factor_dir,
    factor_start_date: Optional[str] = None,
    factor_end_date: Optional[str] = None,
) -> None:
    """
    一键执行因子生成。默认不下载,直接读取本地 parquet。
    你可以在这里指定因子计算的时间窗;后续 strategy/backtest 再指定自己的交易窗。
    """
    print("[start] factor generation")
    process_alligator_from_data(
        data_folder=data_folder,
        factor_folder=factor_folder,
        factor_start_date=factor_start_date,
        factor_end_date=factor_end_date,
    )
    print("[done] factor generation")

run_all(
    factor_start_date="2004-06-30",
    factor_end_date="2025-09-01",
)
10.2. 信号生成
# ============== 策略信号生成 ==============
from __future__ import annotations
import os
from typing import Optional, Dict, List
import pandas as pd

# 需要的列名(由 gen_factor 生成)
REQ_COLS = [
    "trade_date", "open", "high", "low", "close",
    "alligator_jaw", "alligator_teeth", "alligator_lips", "alligator_state",
    "ao", "ao_rising3", "ao_falling3",
    "fractal_up", "fractal_dn", "fractal_up_recent", "fractal_dn_recent",
    "macd_diff", "macd_dea", "macd_hist", "macd_long", "macd_short",
]


def _ensure_dt_index(df: pd.DataFrame) -> pd.DataFrame:
    """确保 trade_date 为升序 DatetimeIndex。"""
    if "trade_date" not in df.columns:
        raise ValueError("缺少 trade_date 列;请先用 gen_factor 生成标准因子文件后再运行 strategy")
    df = df.copy()
    df["trade_date"] = pd.to_datetime(df["trade_date"].astype(str), errors="coerce")
    df = df.dropna(subset=["trade_date"]).set_index("trade_date").sort_index()
    df.index.name = "trade_date"
    return df


def _clip_window(df: pd.DataFrame,
                 start: Optional[str | pd.Timestamp],
                 end: Optional[str | pd.Timestamp]) -> pd.DataFrame:
    if start is not None:
        df = df[df.index >= pd.to_datetime(start)]
    if end is not None:
        df = df[df.index <= pd.to_datetime(end)]
    return df


def generate_trade_signals_alligator_only(df: pd.DataFrame) -> pd.DataFrame:
    """基于 alligator_state 生成 position 与 trade_signal(A 层辅助)。"""
    if "alligator_state" not in df.columns:
        return df
    pos = []
    cur = 0
    vals = df["alligator_state"].astype("string")
    for s in vals:
        if pd.notna(s):
            if s == "bull":
                cur = 1
            elif s == "bear":
                cur = 0
        pos.append(cur)
    df["position"] = pd.Series(pos, index=df.index, dtype="int64")
    prev = df["position"].shift(1).fillna(0).astype(int)
    # trade_signal 表示 T 日收盘后的状态变化:1 从 0->1,-1 从 1->0
    delta = df["position"] - prev
    df["trade_signal"] = delta.where(delta.isin([1, -1]), 0).astype(int)
    return df


def _build_fractal_breakouts(df: pd.DataFrame) -> pd.DataFrame:
    """生成 fractal_long / fractal_short(T 日判定)。
    要求 gen_factor 已经把 fractal_up/dn 用 shift(+2) 发布,并用 ffill 形成 *_recent。
    突破规则:
      long:  close_t > up_recent_{t-1}
      short: close_t < dn_recent_{t-1}
    """
    df = df.copy()
    if {"close", "fractal_up_recent", "fractal_dn_recent"}.issubset(df.columns):
        up_recent_shifted = df["fractal_up_recent"].shift(1)
        dn_recent_shifted = df["fractal_dn_recent"].shift(1)
        valid_long = df["close"].notna() & up_recent_shifted.notna()
        valid_short = df["close"].notna() & dn_recent_shifted.notna()
        df["fractal_long"] = False
        df["fractal_short"] = False
        df.loc[valid_long, "fractal_long"] = (df.loc[valid_long, "close"] > up_recent_shifted.loc[valid_long])
        df.loc[valid_short, "fractal_short"] = (df.loc[valid_short, "close"] < dn_recent_shifted.loc[valid_short])
    else:
        df["fractal_long"], df["fractal_short"] = False, False
    return df


def build_stage_signals(df: pd.DataFrame) -> pd.DataFrame:
    """产出分层信号列:
    - sig_alligator_long/short
    - sig_ao_long/short
    - sig_fractal_long/short
    - sig_macd_long/short
    - sig_combo_long/short (最终组合)
    并提供每层 entries/exits(T 日信号,用于 T+1 执行)。
    """
    df = df.copy()

    # A: Alligator
    df["sig_alligator_long"] = (df.get("alligator_state").astype("string") == "bull")
    df["sig_alligator_short"] = (df.get("alligator_state").astype("string") == "bear")

    # AO 连涨/连跌信号(由 gen_factor 计算)
    df["sig_ao_long"] = df.get("ao_rising3", False).fillna(False)
    df["sig_ao_short"] = df.get("ao_falling3", False).fillna(False)

    # Fractal 突破
    df = _build_fractal_breakouts(df)
    df["sig_fractal_long"] = df["fractal_long"].fillna(False)
    df["sig_fractal_short"] = df["fractal_short"].fillna(False)

    # MACD 四象限合成信号(由 gen_factor 计算)
    df["sig_macd_long"] = df.get("macd_long", False).fillna(False)
    df["sig_macd_short"] = df.get("macd_short", False).fillna(False)

    # D: 最终组合
    df["sig_combo_long"] = df["sig_alligator_long"] & (df["sig_fractal_long"] | df["sig_macd_long"])  # 多头不强制 AO
    df["sig_combo_short"] = (
        df["sig_alligator_short"] | df["sig_ao_short"] | df["sig_fractal_short"] | df["sig_macd_short"]
    )

    # 为回测方便,派生每层 entries/exits(等价于 sig_*)
    df["entries_A"], df["exits_A"] = df["sig_alligator_long"], df["sig_alligator_short"]
    df["entries_B"], df["exits_B"] = (df["sig_alligator_long"] & df["sig_ao_long"]), (df["sig_alligator_short"] | df["sig_ao_short"])
    df["entries_C"], df["exits_C"] = (df["sig_alligator_long"] & df["sig_fractal_long"]), (df["sig_alligator_short"] | df["sig_fractal_short"])
    df["entries_D"], df["exits_D"] = df["sig_combo_long"], df["sig_combo_short"]

    # 保证布尔类型
    bool_cols = [c for c in df.columns if c.startswith("sig_") or c.startswith("entries_") or c.startswith("exits_")]
    for c in bool_cols:
        df[c] = df[c].astype(bool)
    return df


def process_alligator_signals(
    factor_folder: str = "factor",
    output_folder: str = "signals",
    strategy_start_date: Optional[str] = None,
    strategy_end_date: Optional[str] = None,
) -> None:
    """读取因子 parquet,按独立交易时间窗生成信号并写回 parquet。"""
    os.makedirs(output_folder, exist_ok=True)
    files = [f for f in os.listdir(factor_folder) if f.endswith(".parquet")]
    if not files:
        print(f"[warn] 未在 {factor_folder} 找到 parquet 文件")
        return

    for fn in files:
        path = os.path.join(factor_folder, fn)
        ts_code = fn.replace(".parquet", "")
        try:
            df = pd.read_parquet(path)
        except Exception as e:
            print(f"[warn] 读取失败 {path}: {e}")
            continue

        # 基础检查与窗口裁剪
        df = _ensure_dt_index(df)
        # 缺列直接跳过(不强制全部 REQ_COLS,只要生成信号用到的在即可)
        missing = [c for c in ["close", "alligator_state"] if c not in df.columns]
        if missing:
            print(f"[warn] {ts_code} 缺列 {missing},跳过")
            continue

        df_clip = _clip_window(df, strategy_start_date, strategy_end_date)
        if df_clip.empty:
            print(f"[warn] {ts_code} 在策略窗内无数据,跳过")
            continue

        # 生成信号
        df_sig = generate_trade_signals_alligator_only(df_clip)
        df_sig = build_stage_signals(df_sig)

        # 输出 1:完整信号
        out1 = os.path.join(output_folder, f"{ts_code}_trade_signals.parquet")
        df_sig.reset_index().to_parquet(out1, index=False)

        # 输出 2:拆分信号(便于回测脚本直接带入)
        split_cols = [
            "sig_alligator_long", "sig_alligator_short",
            "sig_ao_long", "sig_ao_short",
            "sig_fractal_long", "sig_fractal_short",
            "sig_macd_long", "sig_macd_short",
            "sig_combo_long", "sig_combo_short",
            "entries_A", "exits_A",
            "entries_B", "exits_B",
            "entries_C", "exits_C",
            "entries_D", "exits_D",
            "position", "trade_signal",
        ]
        out2 = os.path.join(output_folder, f"{ts_code}_signals_split.parquet")
        df_sig[split_cols].reset_index().to_parquet(out2, index=False)

        print(f"[ok] {ts_code} -> {out1}; {out2}")


def run_all(
    factor_folder: str = factor_dir,
    output_folder: str = signal_dir,
    strategy_start_date: Optional[str] = None,
    strategy_end_date: Optional[str] = None,
) -> None:
    print("[start] strategy signal generation")
    process_alligator_signals(
        factor_folder=factor_folder,
        output_folder=output_folder,
        strategy_start_date=strategy_start_date,
        strategy_end_date=strategy_end_date,
    )
    print("[done] strategy signal generation")

run_all(
    strategy_start_date="2005-01-04",
    strategy_end_date="2024-01-04",
)
10.3. 回测分析
from matplotlib.ticker import PercentFormatter
import matplotlib.patches as mpatches
import quantstats as qs

def _to_dt_index(df: pd.DataFrame) -> pd.DataFrame:
    df = df.copy()
    if 'trade_date' not in df.columns:
        raise ValueError('missing trade_date column')
    df['trade_date'] = pd.to_datetime(df['trade_date'].astype(str), errors='coerce')
    df = df.dropna(subset=['trade_date']).set_index('trade_date').sort_index()
    df.index.name = 'trade_date'
    return df


def read_split_signals(folder: str, ts_code: str) -> Optional[pd.DataFrame]:
    p1 = os.path.join(folder, f'{ts_code}_signals_split.parquet')
    p2 = os.path.join(folder, f'{ts_code}_alligator_signals_split.parquet')
    path = p1 if os.path.exists(p1) else p2
    if not os.path.exists(path):
        return None
    df = pd.read_parquet(path)
    if 'trade_date' in df.columns:
        df = _to_dt_index(df)
    elif 'index' in df.columns:
        df['index'] = pd.to_datetime(df['index'].astype(str), errors='coerce')
        df = df.dropna(subset=['index']).set_index('index').sort_index()
    return df


def read_price_series(data_folder: str, ts_code: str, col: str) -> pd.Series:
    path = os.path.join(data_folder, f'{ts_code}.parquet')
    if not os.path.exists(path):
        raise FileNotFoundError(f'missing price file: {path}')
    df = pd.read_parquet(path)
    df = _to_dt_index(df)
    if col not in df.columns:
        raise ValueError(f'{path} missing column: {col}')
    return df[col]

# ============================ Backtest engine ============================

def backtest_strategy(entries: pd.Series,
                      exits: pd.Series,
                      open_price: pd.Series,
                      init_cash: float = 1e8,
                      size_granularity: int = 100,
                      fees: float = 0.00015,
                      report_mode: bool = True) -> pd.DataFrame:
    """T-day signal, T+1 open execution; sell first then buy; flat-to-full.
    report_mode=True disables fees and lot size.
    """
    idx = open_price.index.intersection(entries.index).intersection(exits.index)
    if len(idx) < 2:
        return pd.DataFrame()
    px = open_price.loc[idx]
    ent = entries.loc[idx].fillna(False)
    ex  = exits.loc[idx].fillna(False)

    if report_mode:
        fees = 0.0
        size_granularity = 1

    cash_before = init_cash
    cash_after  = init_cash
    position = 0.0

    rows = []
    for i in range(1, len(idx)):
        p = float(px.iloc[i])
        e_prev = bool(ent.iloc[i-1])
        x_prev = bool(ex.iloc[i-1])

        # close first
        if x_prev and position > 0:
            cash_after += position * p * (1 - fees)
            cash_before += position * p
            position = 0.0

        # open after closing
        if e_prev and position == 0:
            if report_mode:
                shares = cash_after / p
            else:
                max_shares = int(cash_after // (p * (1 + fees)))
                shares = (max_shares // size_granularity) * size_granularity
            if shares > 0:
                position = float(shares)
                cash_after -= shares * p * (1 + fees)
                cash_before -= shares * p

        pv_b = cash_before + position * p
        pv_a = cash_after  + position * p
        rows.append((idx[i], pv_b, pv_a, cash_before, cash_after, position))

    res = pd.DataFrame(rows, columns=['date','portfolio_value_before_fees','portfolio_value_after_fees','cash_before','cash_after','position']).set_index('date')
    if len(res):
        res['daily_return_before_fees'] = res['portfolio_value_before_fees'].pct_change()
        res['daily_return_after_fees']  = res['portfolio_value_after_fees'].pct_change()
        res['total_return_before_fees'] = res['portfolio_value_before_fees'] / res['portfolio_value_before_fees'].iloc[0] - 1
        res['total_return_after_fees']  = res['portfolio_value_after_fees']  / res['portfolio_value_after_fees'].iloc[0]  - 1
    return res


def backtest_bond_rotation(entries: pd.Series,
                           exits: pd.Series,
                           stock_open: pd.Series,
                           bond_open: pd.Series,
                           init_cash: float = 1e8,
                           size_granularity: int = 100,
                           fees: float = 0.00015,
                           report_mode: bool = True) -> pd.DataFrame:
    """Equity–Bond rotation: if prev-day wants equity (entry True and not exit) hold equity; else hold bond."""
    idx = stock_open.index.intersection(bond_open.index).intersection(entries.index).intersection(exits.index)
    if len(idx) < 2:
        return pd.DataFrame()
    s_px = stock_open.loc[idx]
    b_px = bond_open.loc[idx]
    ent  = entries.loc[idx].fillna(False)
    ex   = exits.loc[idx].fillna(False)

    if report_mode:
        fees = 0.0
        size_granularity = 1

    cash_before = init_cash
    cash_after  = init_cash
    pos_s = 0.0
    pos_b = 0.0

    rows = []
    for i in range(1, len(idx)):
        ps = float(s_px.iloc[i])
        pb = float(b_px.iloc[i])

        # liquidate existing
        if pos_s > 0:
            cash_after += pos_s * ps * (1 - fees)
            cash_before += pos_s * ps
            pos_s = 0.0
        if pos_b > 0:
            cash_after += pos_b * pb * (1 - fees)
            cash_before += pos_b * pb
            pos_b = 0.0

        want_equity = bool(ent.iloc[i-1]) and not bool(ex.iloc[i-1])
        if want_equity:
            if report_mode:
                shares = cash_after / ps
            else:
                max_shares = int(cash_after // (ps * (1 + fees)))
                shares = (max_shares // size_granularity) * size_granularity
            if shares > 0:
                pos_s = float(shares)
                cash_after -= shares * ps * (1 + fees)
                cash_before -= shares * ps
        else:
            if report_mode:
                shares = cash_after / pb
            else:
                max_shares = int(cash_after // (pb * (1 + fees)))
                shares = (max_shares // size_granularity) * size_granularity
            if shares > 0:
                pos_b = float(shares)
                cash_after -= shares * pb * (1 + fees)
                cash_before -= shares * pb

        pv_b = cash_before + pos_s * ps + pos_b * pb
        pv_a = cash_after  + pos_s * ps + pos_b * pb
        rows.append((idx[i], pv_b, pv_a, cash_before, cash_after, 1 if pos_s > 0 else 0))

    res = pd.DataFrame(rows, columns=['date','portfolio_value_before_fees','portfolio_value_after_fees','cash_before','cash_after','position']).set_index('date')
    if len(res):
        res['daily_return_before_fees'] = res['portfolio_value_before_fees'].pct_change()
        res['daily_return_after_fees']  = res['portfolio_value_after_fees'].pct_change()
        res['total_return_before_fees'] = res['portfolio_value_before_fees'] / res['portfolio_value_before_fees'].iloc[0] - 1
        res['total_return_after_fees']  = res['portfolio_value_after_fees']  / res['portfolio_value_after_fees'].iloc[0]  - 1
    return res

# ============================ Metrics ============================

def calculate_metrics(result_df: pd.DataFrame) -> Dict[str, float]:
    """计算策略指标:quantstats 标准指标 + 自定义仓位指标"""
    if result_df is None or len(result_df) == 0:
        return {}

    returns = result_df['daily_return_after_fees'].dropna()
    if len(returns) == 0:
        return {}

    # ===== quantstats 标准指标(直接调用,不重复计算)=====
    metrics = {
        'annual_return': float(qs.stats.cagr(returns)),
        'max_drawdown': float(qs.stats.max_drawdown(returns)),
        'sharpe': float(qs.stats.sharpe(returns)),
        'calmar': float(qs.stats.calmar(returns)),
        'daily_win_rate': float(qs.stats.win_rate(returns)),
    }

    # ===== 自定义指标(quantstats 没有的)=====
    # 盈亏比
    positive_returns = returns[returns > 0]
    negative_returns = returns[returns < 0]
    metrics['daily_profit_loss_ratio'] = float(
        positive_returns.mean() / abs(negative_returns.mean())
    ) if len(negative_returns) > 0 and negative_returns.mean() != 0 else 0.0

    # 仓位相关指标
    position_data = result_df.get('position', pd.Series(0, index=result_df.index))
    full_position_returns = returns[position_data > 0]
    empty_position_returns = returns[position_data == 0]

    metrics['full_position_win_rate'] = float((full_position_returns > 0).mean()) if len(full_position_returns) > 0 else 0.0
    metrics['empty_position_win_rate'] = float((empty_position_returns > 0).mean()) if len(empty_position_returns) > 0 else 0.0
    metrics['empty_position_ratio'] = float((position_data == 0).sum() / len(position_data)) if len(position_data) > 0 else 0.0

    # 交易次数和换手率
    trade_signals = result_df.get('trade_signal', pd.Series(0, index=result_df.index))
    total_trades = (trade_signals != 0).sum()
    total_days = len(result_df)

    metrics['total_trades'] = int(total_trades)
    metrics['annual_turnover'] = float(total_trades / (total_days / 365.25)) if total_days > 0 else 0.0
    metrics['monthly_turnover'] = float(total_trades / (total_days / 30.44)) if total_days > 0 else 0.0
    metrics['avg_holding_days'] = float(total_days / total_trades) if total_trades > 0 else 0.0

    return metrics

# ============================ Report-style plotting ============================

def _plot_report(returns: pd.Series, benchmark_returns: pd.Series, title: str, outpath: str) -> None:
    """策略对比图表:净值曲线 + 从上往下的半透明绿色回撤区域"""
    if returns is None or len(returns) < 2:
        return

    os.makedirs(os.path.dirname(outpath) or '.', exist_ok=True)

    # 计算累积收益
    cum = (1 + returns).cumprod()
    bench = benchmark_returns if benchmark_returns is not None and len(benchmark_returns) > 0 else None

    # 回撤负值 -> 幅度正数
    dd = qs.stats.to_drawdown_series(returns).fillna(0)
    dd_mag = (-dd).clip(lower=0)  # 正数

    # 创建图表
    fig, ax1 = plt.subplots(figsize=(16, 8))

    # 先画累计收益线(黑色)
    ax1.plot(cum.index, cum.values, linewidth=2.0, color='#FF0000', label='Strategy', zorder=3)

    # 基准可选(深灰)
    if bench is not None:
        cum_bench = (1 + bench).cumprod()
        ax1.plot(cum_bench.index, cum_bench.values, linewidth=1.4, color='#777777', label='Benchmark', zorder=2)

    ax1.set_ylabel('Net Asset Value', fontsize=12)
    ax1.set_xlabel('Date', fontsize=12)
    ax1.grid(True, alpha=0.3, zorder=0)

    # 右轴:回撤用半透明绿色
    ax2 = ax1.twinx()
    ax1.set_zorder(ax2.get_zorder() + 1)
    ax1.patch.set_visible(False)

    # 关键:绿色 + 透明度
    ax2.fill_between(
        dd_mag.index, 0, dd_mag.values * 100,
        facecolor=(0.0, 0.55, 0.0, 0.35),  # 深绿,35%透明
        edgecolor='none',
        zorder=1
    )

    # 让回撤从上往下灌
    hi = dd_mag.max() * 100
    ax2.set_ylim(hi * 1.05, 0)
    ax2.set_ylabel('Drawdown (%)', fontsize=12)
    ax2.yaxis.set_major_formatter(PercentFormatter(xmax=100))

    # 标题
    ax1.set_title(title, fontsize=16, pad=20)

    # 图例:给回撤补一个绿色块
    handles, labels = ax1.get_legend_handles_labels()
    handles.append(mpatches.Patch(facecolor=(0.0, 0.55, 0.0, 0.35), edgecolor='none', label='Drawdown'))
    ax1.legend(handles=handles, loc='upper left', frameon=False, fontsize=11)

    plt.tight_layout()
    plt.savefig(outpath, dpi=100, bbox_inches='tight')
    plt.close()


def plot_reports_for_results(results: Dict[str, dict], bench_close: pd.Series, ts_code: str, out_dir: str) -> Dict[str, str]:
    """为每个策略生成对比报告图表"""
    out = {}
    order = [
        ('1_Alligator',                    '1. Alligator'),
        ('B_Alligator_AO',                 '2. Alligator + AO'),
        ('C_Alligator_Fractal',            '3. Alligator + Fractal'),
        ('D_Alligator_AO_Fractal',         '4. Alligator + AO + Fractal'),
        ('E_Alligator_AO_Fractal_MACD',     '5. Alligator + AO + Fractal + MACD'),
        ('E_Bond_Rotation',                '6. Equity–Bond Rotation'),
    ]

    # 计算基准收益率
    bench_returns = bench_close.pct_change().dropna()

    for key, ttl in order:
        if key not in results or 'result_df' not in results[key] or results[key]['result_df'] is None or len(results[key]['result_df']) == 0:
            continue

        res_df = results[key]['result_df']
        strategy_returns = res_df['daily_return_after_fees'].dropna()

        if len(strategy_returns) < 2:
            continue

        # 对齐基准收益率
        aligned_bench_returns = bench_returns.reindex(strategy_returns.index).fillna(0)

        # 将图表保存到各自的资产文件夹中
        f = f'{out_dir}/{ts_code}/report_{key}.png'

        _plot_report(strategy_returns, aligned_bench_returns, f'{ts_code} — {ttl}', f)
        out[key] = f

    return out

# ============================ Orchestrator ============================


def run_staged_backtest(ts_code: str = '000300.SH',
                        signal_folder: str = signal_dir,
                        factor_folder: str = factor_dir,
                        data_folder: str = data_dir,
                        report_mode: bool = True,
                        report_folder: str = report_dir,
                        backtest_start_date: Optional[str] = None,
                        backtest_end_date: Optional[str] = None,
                        bond_code: str = 'CBA00101.CS') -> Dict[str, dict]:
    sig = read_split_signals(signal_dir, ts_code)
    if sig is None:
        raise FileNotFoundError('missing split signals; run strategy.py first')

    open_px  = read_price_series(data_folder, ts_code, col='open')
    close_px = read_price_series(data_folder, ts_code, col='close')

    # clip window
    if backtest_start_date is not None:
        dt0 = pd.to_datetime(backtest_start_date)
        open_px  = open_px[open_px.index   >= dt0]
        close_px = close_px[close_px.index >= dt0]
        sig      = sig[sig.index           >= dt0]
    if backtest_end_date is not None:
        dt1 = pd.to_datetime(backtest_end_date)
        open_px  = open_px[open_px.index   <= dt1]
        close_px = close_px[close_px.index <= dt1]
        sig      = sig[sig.index           <= dt1]

    idx = open_px.index.intersection(sig.index)
    if len(idx) < 2:
        raise RuntimeError('not enough overlapping dates for backtest')
    px  = open_px.loc[idx]
    sig = sig.loc[idx].fillna(False)

    # 策略配置:避免重复代码
    strategies = [
        ('1_Alligator', sig['sig_alligator_long'], sig['sig_alligator_short']),
        ('B_Alligator_AO', sig['sig_alligator_long'] & sig['sig_ao_long'], sig['sig_alligator_short'] | sig['sig_ao_short']),
        ('C_Alligator_Fractal', sig['sig_alligator_long'] & sig['sig_fractal_long'], sig['sig_alligator_short'] | sig['sig_fractal_short']),
        ('D_Alligator_AO_Fractal', sig['sig_alligator_long'] & sig['sig_ao_long'] & sig['sig_fractal_long'], sig['sig_alligator_short'] | sig['sig_ao_short'] | sig['sig_fractal_short']),
        ('E_Alligator_AO_Fractal_MACD', sig['sig_combo_long'], sig['sig_combo_short']),
    ]

    results: Dict[str, dict] = {}

    for key, entries, exits in strategies:
        res = backtest_strategy(entries.astype(bool), exits.astype(bool), px, report_mode=report_mode)
        if 'trade_signal' in sig.columns and 'position' in sig.columns:
            res['trade_signal'] = sig['trade_signal']
            res['position'] = sig['position']
        results[key] = {'result_df': res}

    # Bond rotation strategy (Equity–Bond)
    try:
        bond_open = read_price_series(data_folder, bond_code, col='open')
        if bond_open.isna().all():
            bond_open = read_price_series(data_folder, bond_code, col='close')

        idx2 = px.index.intersection(bond_open.index)
        if len(idx2) >= 2:
            rot = backtest_bond_rotation(
                sig['sig_combo_long'].reindex(idx2).fillna(False),
                sig['sig_combo_short'].reindex(idx2).fillna(False),
                px.reindex(idx2),
                bond_open.reindex(idx2),
                report_mode=report_mode
            )
            if 'trade_signal' in sig.columns and 'position' in sig.columns:
                rot['trade_signal'] = sig['trade_signal'].reindex(idx2)
                rot['position'] = sig['position'].reindex(idx2)
            results['E_Bond_Rotation'] = {'result_df': rot}
    except Exception as e:
        print(f'[warn] Bond rotation skipped: {e}')

    # plot report-only charts
    plot_reports_for_results(results, bench_close=close_px, ts_code=ts_code, out_dir = report_folder)

    return results

def save_results_to_csv(results: Dict[str, dict], ts_code: str, output_folder: str = report_dir) -> pd.DataFrame:
    """保存策略对比结果到CSV文件"""
    name_map = {
        '1_Alligator': '1. Alligator',
        'B_Alligator_AO': '2. Alligator + AO',
        'C_Alligator_Fractal': '3. Alligator + Fractal',
        'D_Alligator_AO_Fractal': '4. Alligator + AO + Fractal',
        'E_Alligator_AO_Fractal_MACD': '5. Alligator + AO + Fractal + MACD',
        'E_Bond_Rotation': '6. Equity–Bond Rotation',
    }

    # 计算所有策略的指标
    data = {}
    for k, v in results.items():
        if 'result_df' in v and v['result_df'] is not None and len(v['result_df']) > 0:
            data[name_map.get(k, k)] = calculate_metrics(v['result_df'])

    df = pd.DataFrame(data).T

    # 保存到文件
    asset_folder = os.path.join(output_folder, ts_code)
    os.makedirs(asset_folder, exist_ok=True)
    out = os.path.join(asset_folder, f'{ts_code}_strategies_comparison.csv')
    df.to_csv(out)
    print(f'Metrics saved: {out}')
    return df


def run_all(ts_codes: list[str],
            report_mode: bool = True,
            strategy_start_date: Optional[str] = None,
            strategy_end_date: Optional[str] = None,
            bond_code: str = 'CBA00101.CS') -> None:
    """运行所有标的的回测分析"""
    print('Starting staged backtests with quantstats...')
    for code in ts_codes:
        print(f'\nSymbol: {code}')
        res = run_staged_backtest(
            ts_code=code,
            report_mode=report_mode,
            backtest_start_date=strategy_start_date,
            backtest_end_date=strategy_end_date,
            bond_code=bond_code
        )
        if res:
            save_results_to_csv(res, ts_code=code)
    print('\nDone.')


run_all(report_mode=True, ts_codes = universe)
attention
请在 /reports/alligator 目录下查看回测结果。关于本文作者
Jerrick Rex,金融工程专业,多次参与数学建模竞赛,获美国大学生数学建模竞赛 F 奖;曾在燧石等量化基金公司从业实习。平时热爱量化研究,也在高频量化基金公司里有实习经历,参与因子研究、回测与数据管线搭建,把想法用代码落地是我的日常。我相信研究的价值在于被验证、被使用、被迭代。保持好奇、保持乐观、持续复盘,市场会奖励认真和自律的人。欢迎交流,一起把复杂的问题研究明白。